

1. 서 론
2. 실험 방법
2.1. 데이터
2.2. 기계학습 모델 최적화
2.3. 조건부 변분 자동 인코더(conditional variational autoencoder, CVAE)
2.4. 다중 목적 베이지안 최적화
3. 결과 및 고찰
4. 결 론
1. 서 론
고엔트로피 합금(high-entropy alloy, HEA)은 최소 다섯 가지 이상 주원소가 각각 5~35 at% 범위의 함량으로 포함되는 합금으로 정의된다.1) HEA는 높은 강도2)와 우수한 내마모성3) 등 뛰어난 기계적 물성을 보인다. 이러한 이유로 2004년에4) 보고된 이후 HEA는 지속적인 연구가 이어지고 있다. HEA는 여러 특성이 우수하지만, 강도와 연성 두 가지 기계적 특성은 상충관계를 보여 동시에 충족하는 조성을 찾기는 쉽지 않다.5,6) 이를 해결하기 위해 열역학 계산(CALPHAD),7) 고처리량 실험,8) 전통적 실험 기반 설계 등9) 다양한 방법이 시도되어 왔지만, 방대한 조성 공간을 효율적으로 탐색하기에는 비용과 시간이 과도하게 소요된다. 최근에는 데이터 기반 기계학습이 벌크 금속유리(bulk metallic glasses, BMGs),10) 텅스텐 합금,11) 강철 합금12) 등 여러 합금 설계의 효율성을 크게 높일 수 있는 대안으로 주목받고 있으며, 특히 생성 모델을 이용한 조성 탐색과 베이지안 최적화 기반 능동 학습이 강력한 탐색 전략으로 자리매김하고 있다. 최근 연구 사례에서는 변분 자동 인코더(variational autoencoder, VAE)를 학습시켜 잠재 공간에서 1,500여 개의 신규 조성을 생성하고, 기계학습 예측모델로 최대 인장 강도(ultimate tensile strength, UTS) 1 GPa 이상의 특성과 총 연신율(total elongation) 15 % 이상 조건을 만족하는 후보 32종을 선별하여 열처리 후 실험으로 검증하였다.13)
또 다른 연구 사례에서는 원소 조성 규칙을 설정한 제약 하에 다중 목적 부피증가 기대효과(expected hypervolume improvement, EHVI) 기반 베이지안 최적화-능동 학습을 수행한 결과, 초기 20개 조성에서 6회 만에 최대 인장 강도 ≈ 1.3 GPa, 총 연신율 ≈ 22 %의 HEA 조성을 실험적으로 달성하였다.14) 또한 소재 기반 도메인 지식과 기계학습을 결합한 단일 목적 최적화 기반 능동 학습을 수행한 결과, 초기 140개의 합금 데이터베이스에서 4회 만에 항복 강도(σy) ≈ 1.8 GPa와 균일 연신율(εu) ≈ 25 %를 동시에 만족하는 FeNiCoAlTa계 HEA 조성을 실험적으로 확인하였다.15)
기존 연구는 조건을 부여하지 않는 일반 VAE로 조성을 생성했지만,13) 본 연구는 목표 물성 범위를 조건으로 입력하는 조건부 변분 자동 인코더(conditional variational autoencoder, CVAE)를 통해 사용자가 요구하는 특성을 만족하는 조성을 직접 생성하였다. 이를 통해 불필요한 후보를 효과적으로 제거하여 계산 또는 실험 비용을 획기적으로 절감하고 효율성이 크게 향상되는 장점이 있다. 기존의 베이지안 최적화-능동 학습 기반 탐색은 정해진 후보군을 탐색하는 이산 탐색이거나 단일 목표를 최적화하는 경우가 대부분이다. 본 연구에서는 두 가지 물성을 목표로 하여 Sobol 시퀀스로 생성한 초기 샘플을 기반으로 L-BFGS-B를 통해 획득함수를 연속 최적화하였다. 연속 최적화는 연속적인 조성 공간 전체를 부드럽게 탐색함으로써 차원이 높아도 계산량이 기하급수적으로 늘어나지 않고, 선형 제약을 그대로 반영한 상태에서 파레토 프론트를 가장 크게 확장할 가능성이 높은 조성을 직접 찾아낼 수 있다는 장점이 있다. 또한 지금까지의 연구는 생성 모델 기반 탐색과 베이지안 최적화 기반 탐색을 동일한 데이터와 예측 모델 조건에서 정량적으로 비교한 사례가 드물어, 두 전략의 상대적 장단점과 보완 가능성에 대한 체계적 검증이 부족하다.
본 연구는 여러 문헌에서 수집한 HEA 데이터를 이용해 최대 인장 강도와 총 연신율 각각의 물성에 대해 여러 기계 학습 모델인 딥러닝 신경망(deep neural network, DNN), 그래디언트 부스팅(extreme gradient boosting, XGBoost), 랜덤 포레스트(random forest, RF) 모델을 하이퍼-파라미터 최적화 기반으로 학습한 후, 예측 성능이 두 가지 물성에 대해 가장 우수한 XGBoost 모델을 최종 선택하였다. 이후 두 가지 물성이 평균값을 초과하여 두 가지 물성이 동시에 우수한 영역을 조건으로 정의하고, 해당 조건을 만족하도록 CVAE를 사용하여 잠재 공간에서 1,000개의 조성을 생성하였다. 다음으로 다중 목적 최적화 관점에서 최대 인장 강도와 총 연신율을 동시에 고려하여, 두 물성이 서로 상충하는 관계를 나타내는 파레토 프론트를 기반으로 하여 다중 목적 베이지안 최적화를 적용해 EHVI를 기반으로 5개의 후보 물질을 추천 받았다. 마지막으로, 서로 다른 두 방법으로 얻은 조성들에 대해, 앞서 최적화한 XGBoost 모델을 통해 최대 인장 강도와 총 연신율을 예측하고 CVAE 기반 생성 기법과 베이지안 최적화 두 가지 방법을 비교하였다.
2. 실험 방법
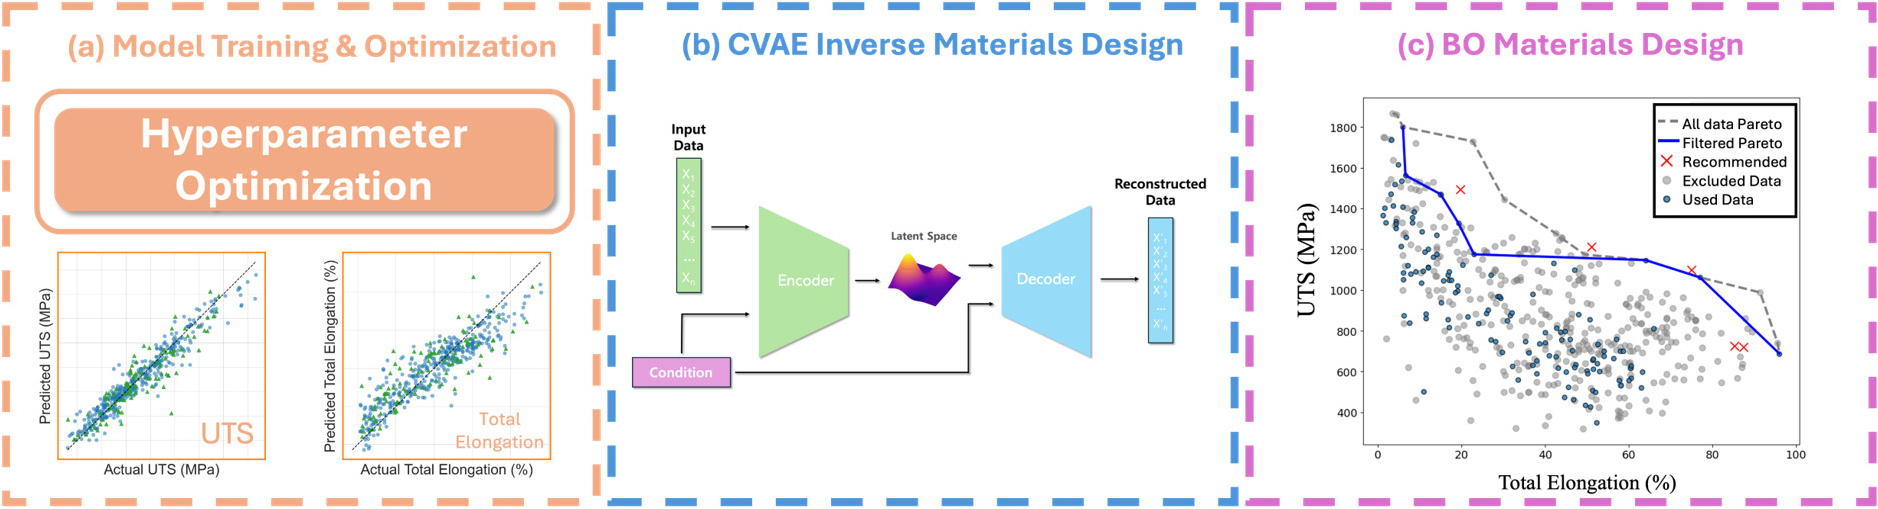
Fig. 1은 본 연구의 프레임워크를 나타낸 그림이다. 본 연구는 3단계로 구성되어 있다. 첫째 HEA 데이터를 문헌에서 수집하였다.6) 데이터에는 10가지 합금의 조성 비율과 4가지 실험 조건, 최대 인장 강도와 총 연신율 물성을 포함하고 있다. 각각의 물성에 대해 여러 기계 학습 모델을 하이퍼파라미터 최적화 기반으로 학습한 후, 예측 성능이 두 가지 물성에 대해 동시에 가장 우수한 XGBoost 모델을 최종 선택하였다. 둘째 최대 인장 강도와 총 연신율 각각의 물성이 평균값을 초과하여 기계적으로 우수한 물성을 보이는 영역을 목표 구간으로 정의하고, 해당 조건을 만족하도록 CVAE를 사용하여 잠재 공간에서 1,000개의 조성을 생성하였다. 셋째 다중 목적 최적화 관점에서 최대 인장 강도와 총 연신율을 동시에 고려하여, 두 특성이 서로 상충하는 관계를 나타내는 파레토 프론트를 기반으로 하여 다중 목적 베이지안 최적화를 적용해 EHVI를 기반으로 5개의 후보 물질을 추천 받았다. 서로 다른 두 방법으로 얻은 조성들에 대해, 앞서 최적화한 XGBoost 모델을 이용해 물성을 예측하고 상호 비교하였다.
2.1. 데이터
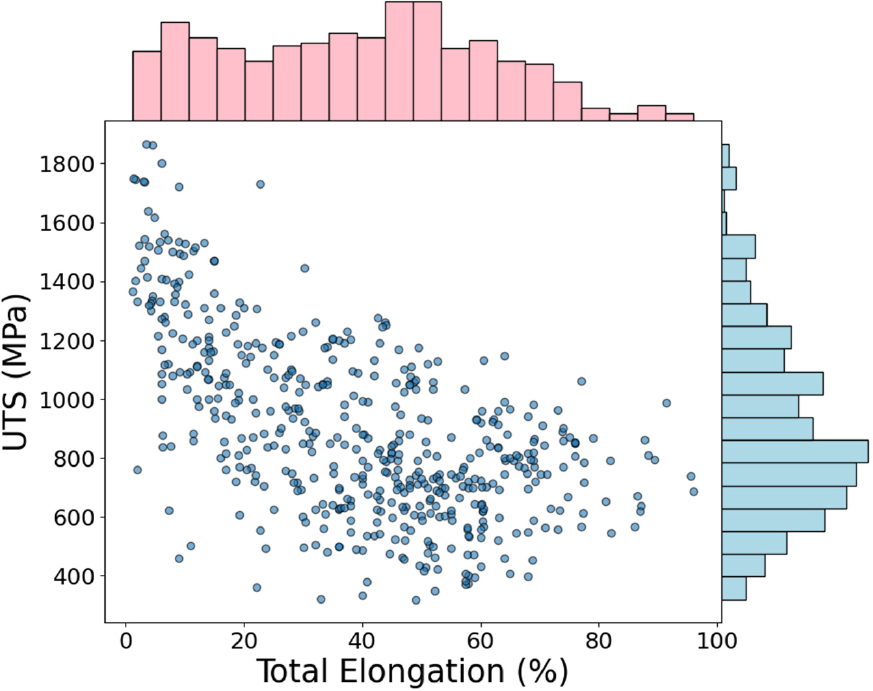
본 연구는 문헌 기반의 501개 HEA 데이터를 바탕으로 하며, 조성은 C, Al, V, Cr, Mn, Fe, Co, Ni, Cu, Mo 등 10가지 원소로 구성되어 있다. 해당 데이터셋에는 기계적 특성과 함께, 균질화 온도(0-1,573 K), 냉간 압연율(0-96 %), 열처리 온도(0-1,573 K), 열처리 시간(0-50 h)의 네 가지 실험 조건이 포함되어 있다.6)Fig. 2는 501개의 HEA 소재의 최대 인장 강도와 총 연신율의 분포, 그리고 두 물성 간 산점도를 나타낸 그림이다. 최대 인장 강도는 약 320 MPa에서 1,867 MPa까지 분포하고 있으며 총 연신율은 1.16 %에서 96 %까지 분포하고 있다. 산점도는 최대 인장 강도와 총 연신율 사이에 상충되는 관계가 존재함을 보여준다. 고강도와 고연성을 동시에 만족하는 조성을 확보하기 위해서는 다중 목적 최적화 기법을 활용해 두 목표 사이의 균형점을 탐색할 필요가 있음을 의미한다.
2.2. 기계학습 모델 최적화
본 연구에서는 두 가지 방법으로 생성된 데이터를 평가하기 위해 최대 인장 강도와 총 연신율을 예측하는 기계학습 모델을 각각 학습 및 최적화하였다. 사용된 모델은 RF, XGBoost, DNN 세 가지이며 전체 데이터셋을 80 %는 학습용, 20 %는 테스트용으로 분할하여 각 모델을 학습시키고 평가하였다. 모델의 평가는 테스트용 데이터의 결정 계수(R2 score)와 평균 제곱근 오차(root-mean-squared-error, RMSE)를 확인하는 방식으로 수행되었으며 식 (1)과 (2)는 각각 결정 계수와 평균 제곱근 오차를 계산하는 수식이다. 여기서 는 실제 관측 값을, 는 모델이 예측한 값을 의미한다. 는 실제 관측 값들의 평균을 나타내며, 은 전체 데이터 샘플의 개수를, 는 각 데이터 샘플을 나타낸다.
DNN 모델은 입력으로 조성과 실험 조건을 포함한 14개 특성을 입력으로 사용하며, 3개의 은닉층과 드롭 아웃층으로 구성되며 ReLU 활성화 함수를 가진다. 학습은 100 에포크를 수행하였으며, 100번 반복하여 각기 다른 가중치를 갖는 모델 100개를 얻었다. 학습된 100개 DNN 모델 중 테스트 데이터에 대한 결정 계수가 가장 높은 모델을 DNN 대표 모델로 선정하였다. XGBoost와 RF 모델의 최적화는 10-fold 교차 검증을 기반으로 베이지안 최적화를 통해 수행하였다.
2.3. 조건부 변분 자동 인코더(conditional variational autoencoder, CVAE)
CVAE는 조건부 정보를 활용하여 연속형 변수를 갖는 조성을 생성하기 위한 잠재 공간을 구성하는 딥러닝 기반 생성 모델이다. CVAE는 VAE 구조를 기반으로 하지만 입력 데이터뿐만 아니라 특정 조건을 함께 인코더와 디코더에 입력하여 조건에 따라 제어된 데이터 생성을 가능하게 한다. 입력 데이터와 조건 정보는 인코더를 통해 다변량 정규분포(multivariate normal distribution)를 따르는 확률변수로 매핑된다. 이후 이 잠재변수(Z)와 조건 정보를 함께 디코더에 입력하여 조건에 부합하는 데이터를 재구성하게 된다.
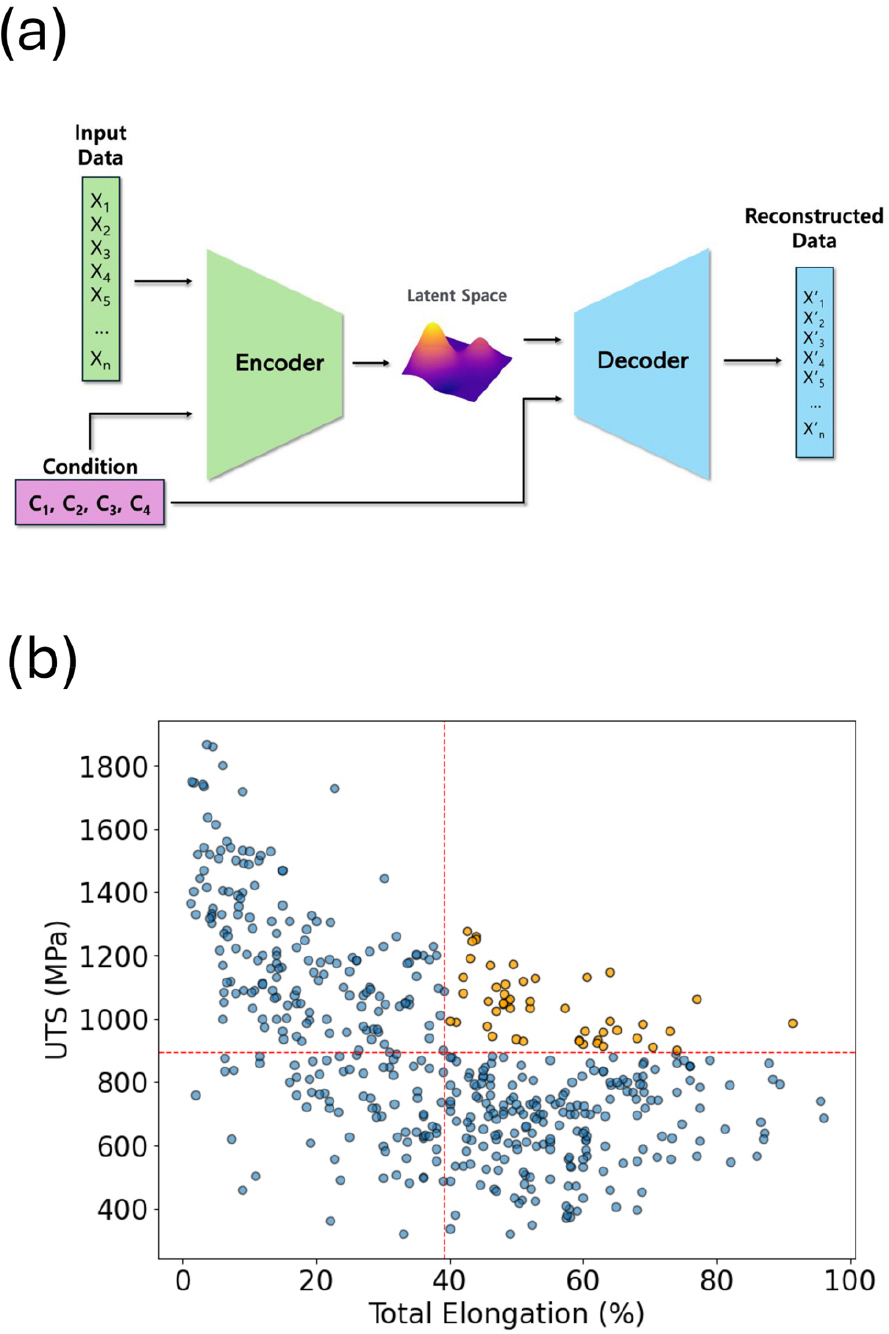
본 연구에서는 파이토치(PyTorch) 기반의 CVAE를 활용하여 새로운 데이터를 생성하였다. CVAE 모델의 입력 변수로는 10개 원소 조성과 4가지 실험 조건, 총 14개의 특성을 사용하였다. 조건은 최대 인장 강도와 총 연신율의 평균값을 기준으로 각각을 상위 및 하위 영역으로 나눈 뒤, 이들을 조합하여 총 네 가지 조건을 구성하였다. 이 중 두 가지 물성에서 우수한 성능을 보이는 평균 이상 영역(최대 인장 강도 ≈ 895.0 MPa, 총 연신율 ≈ 39.0 %)에 해당하는 데이터를 조건으로 하여 1,000개의 새로운 데이터를 생성하였다. CVAE 모델의 구조와 생성에 사용된 조건에 대한 시각화는 Fig. 3(a)와 (b)에서 확인 가능하다. 이 중 물리적으로 구현이 불가능한 실험 조건을 제외하고, 총 310개의 데이터를 최종 평가 대상으로 선정하였다.
2.4. 다중 목적 베이지안 최적화
베이지안 최적화 기법을 활용하여 최대 인장 강도와 총 연신율을 동시에 만족하는 고성능 조성 후보를 탐색하였다. 능동 학습은 대리모델의 불확실성과 획득함수 값을 함께 고려해 다음 샘플을 선택하는 전략이다. 이때 획득함수 값은 대리모델의 평균과 표준편차를 조합하여 결정된다. 예측 불확실성이 크거나 잠재 성능이 높은 지점을 우선 선택한다. 새로 얻은 데이터를 반영해 모델을 재학습하며 탐색-실험-업데이트 과정을 반복한다.
본 연구의 최적화 과정에서는 대리 모델로는 가우시안 프로세스 회귀(gaussian process regression, GPR) 모델을, 획득 함수로는 EHVI를 적용하였다. 최적화 워크플로우 구현을 위해서 실험 조건은 원본 데이터셋에 포함된 값들의 범위를 기준으로 제한하였고, 조성은 각 원소 비율의 합이 100 %가 되도록 제한 조건을 설정하였다. 이와 같은 조건 하에서 EHVI 기반 최적화를 통해 다중 목적 목표를 만족하는 상위 5개의 조성 후보를 추천 받았다. 위 두 가지 방법으로 얻은 데이터를 비교 및 평가하였으며 결과 및 고찰에서 자세히 설명할 것이다.
3. 결과 및 고찰
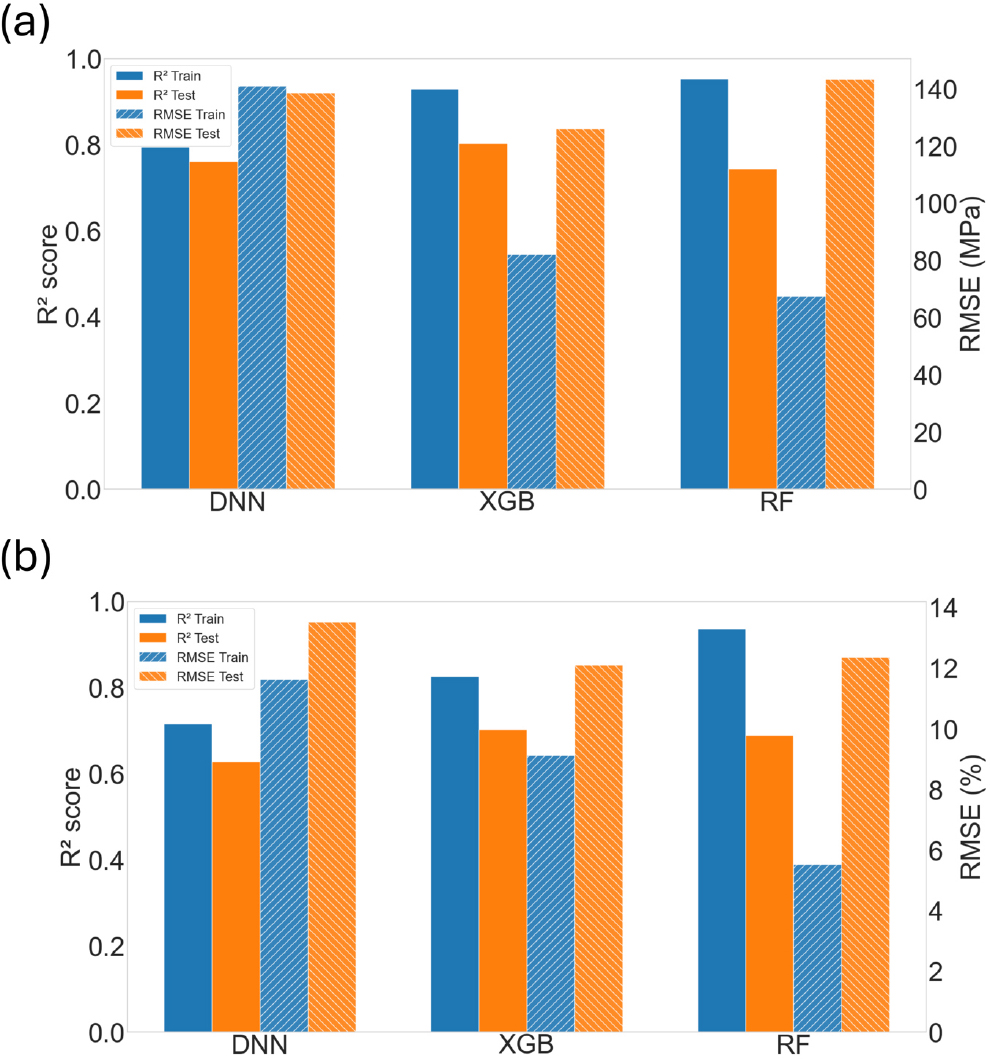
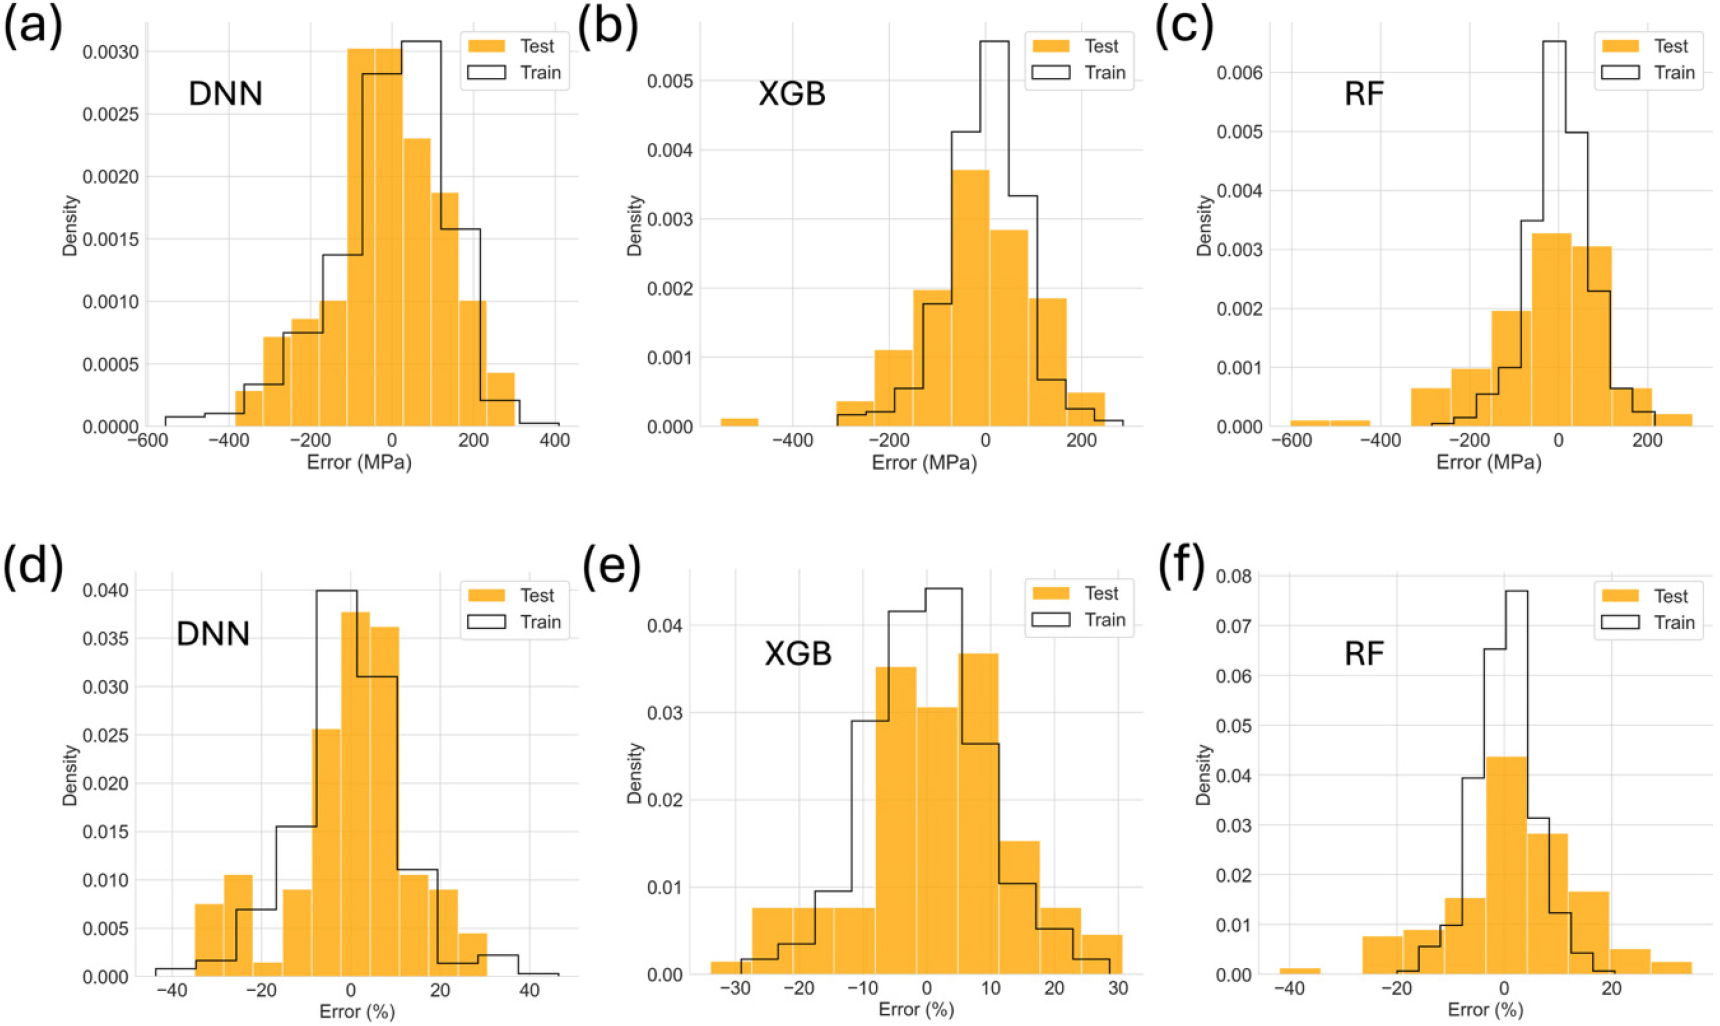
Fig. 4는 각 모델의 학습과 테스트에 대한 자세한 성능을 막대 그래프로 나타낸 그림이다. XGBoost 모델이 최대 인장 강도 예측에서 테스트 데이터 기준 결정 계수 0.803, 평균 제곱근 오차 125.9 MPa를 나타내어 DNN의 0.761, 138.6 MPa와 RF의 0.744, 143.3 MPa 대비 높은 결정 계수와 평균 제곱근 오차를 기록하였다. 총 연신율 예측에서도 XGBoost 모델은 결정 계수 0.702, 평균 제곱근 오차 12.102 %로 DNN의 0.628, 13.519 %와 RF의 0.689, 12.356 %를 모두 상회하는 성능을 보였다. 다음으로 학습 데이터와 테스트 데이터에 대해 잔차 오차를 계산하였다. 양의 오차는 실제 값보다 더 크게 예측한 것을 의미하며 음의 오차는 실제 값보다 작게 예측된 것을 의미한다. Fig. 5는 각 모델(DNN, XGBoost, RF)의 학습 및 테스트 데이터의 잔차 분포를 나타낸 히스토그램이다. 일부의 높은 오차 데이터를 제외하면 대부분의 오차가 0 부근에 위치하며 정규 분포의 형태를 보인다. 이 중 XGBoost 모델이 가장 낮은 음의 오차 범위를 보이는 것을 확인할 수 있다. 따라서 본 연구는 세 모델 중 가장 우수한 성능 지표를 확보한 XGBoost를 최종 예측 모델로 선정하였다.
HEA의 조성이 최대 인장 강도와 총 연신율에 미치는 영향을 정량적으로 분석하고자 샤플리 가산 설명(shapley additive explanations, SHAP) 값을 활용한 특성 중요도 분석을 수행하였다. SHAP은 게임이론을 기반으로 각 예측값에 대한 개별 특성의 기여도를 계산하여, 인공지능 모델의 예측 과정을 해석할 수 있도록 하는 기법이다.16)Fig. 6은 두 가지 물성을 목표값으로 하여 입력 특성별 SHAP 값의 퍼짐을 시각화한 그림이다. 그림의 가로 막대는 각 입력 특성에 대해 SHAP 값이 얼마나 넓게 퍼져 있는지를 나타낸다. 막대가 길수록 그 특성이 영향이 큰 특성임을 뜻하며, 우측의 컬러바는 각 특성에서 관측된 특성값의 크기를 나타낸다. Fig. 6(a)와 (b)에서 냉간 압연율, 열처리 온도, 알루미늄의 비율은 최대 인장 강도와 총 연신율 두 가지의 물성을 예측하는 데 있어 큰 영향을 미치는 주요 특성임을 확인할 수 있다.
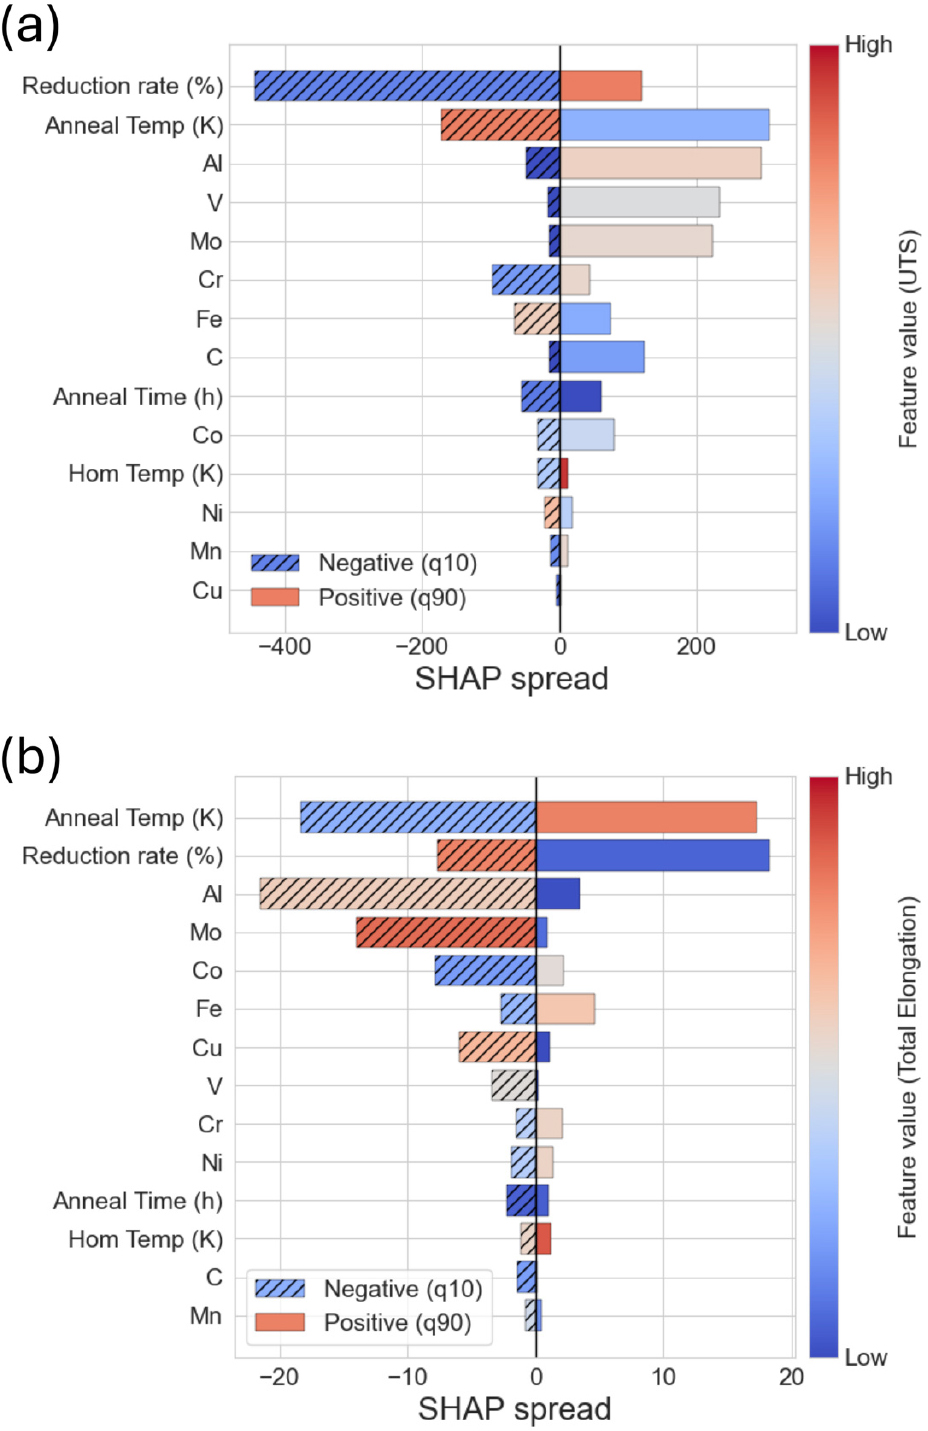
냉간 압연율은 최대 인장 강도에 대해 특성 값이 증가함에 따라 모델 예측값을 증가시키는 것이 확인되지만 반대로 총 연신율에 있어서는 모델 예측값을 감소시키는 방향으로 작용한다. 마찬가지로 열처리 온도의 증가는 최대 인장 강도 예측값을 감소시키는 방향으로 작용하지만 총 연신율의 예측값은 증가시키는 방향으로 작용한다. 알루미늄 함량의 경우에도 최대 인장 강도에 있어 함량이 증가함에 따라 모델 예측값을 증가시키지만 총 연신율에 있어서는 모델 예측값을 감소시키는 방향으로 작용하여 상반된 영향을 미친다. 이러한 특성 값 변화에 따른 모델의 예측값 변화 추세는 두 목표값에 대한 특성들 간의 상충 관계를 의미하며 이는 기존 실험으로 보고된 결과와 일치한다. 자세한 사례는 다음과 같다.
Al0.25CoCrFeNi HEA 합금의 경우 냉간 압연율을 0 %에서 90 %까지 증가시켰을 때 최대 인장 강도는 526 MPa에서 1,479 MPa로 약 2.8배 향상되었다.17) 또한, 90 % 냉간 압연된 CrMnFeCoNi 합금 역시 약 1,400 MPa의 높은 최대 인장 강도를 나타내는 것으로 보고되었다.18) 반면, 총 연신율은 냉간 압연율이 증가함에 따라 급격히 감소하는 경향을 보인다. AlCoCrFeNi2.1 eutectic high entropy alloy의 경우 냉간 압연율이 90 %일 때 총 연신율이 17 %에서 6 %로 크게 감소하는 것이 관찰되었다.19) 열처리 온도 역시 최대 인장 강도와 연신율에 서로 다른 영향을 미친다. 기존에 보고된 연구 사례에서 500 °C 열처리에서는 침전 경화로 인해 최대 인장 강도에 도달하지만, 온도가 1,100 °C까지 증가함에 따라 침전물의 용해와 결정립 성장으로 인해 2차상이 소멸되며 단일 FCC 구조로 회복되면서 강도는 점차 감소하고 연성은 크게 향상되는 경향을 보인다.20) 또 다른 연구에서도 냉간 압연 시편은 450 °C에서 최대 인장 강도 약 1,400 MPa를 기록한 후, 700 °C 이상에서는 강도가 감소하며, 열간 압연 시편은 450 °C 이후 열처리 온도가 높아질수록 지속적인 강도 감소가 나타나는 것이 확인되었다.18) 앞서 언급된 AlCoCrFeNi2.1 EHEA의 경우 냉간 압연 후 총 연신율이 감소했지만, 후속 열처리를 800 °C에서 1,200 °C로 수행할 경우 연신율은 12 %에서 27 %까지 크게 향상되는 결과를 보였다.19) 알루미늄 함량 또한 두 물성에 서로 반대되는 영향을 미친다. AlXCoCr3Fe3Ni HEA에서는 Al 함량이 증가함에 따라 최대 인장 강도가 643.3 MPa에서 1018.9 MPa까지 향상되었으나, 동시에 재료가 파단될 때까지의 총 연신율은 55.0 %에서 16.1 %로 크게 감소하였다.21) 이러한 연구 결과들은 두 가지 물성을 목표값으로 학습된 XGBoost 모델이 냉간 압연율, 열처리 온도, 알루미늄의 함량의 영향을 정확히 포착하고 있음을 보여주며, SHAP 분석에서 중요한 특성들의 특성 값 변화 추세가 물리적 특성과 일치하여 XGBoost 모델의 해석이 타당함을 뒷받침한다.
Fig. 7은 학습된 CVAE 모델의 잠재 공간을 나타내며, Fig. 7(a)의 색 표시 막대는 최대 인장 강도, Fig. 7(b)의 색 표시 막대는 총 연신율을 각각 표현한다. 파란색과 초록색 원으로 표시된 잠재 공간에서는 최대 인장 강도와 총 연신율 간에 뚜렷한 상충 관계가 확인되며, 초록색 원으로 표시된 공간에서는 총 연신율이 높게, 최대 인장 강도가 낮게 나타났다. 반면, 파란색 원으로 표시된 공간에서는 최대 인장 강도가 높게, 총 연신율이 낮게 나타나는 경향을 보인다. Fig. 7(c)는 잠재 공간에서 1,000개의 데이터를 생성한 z의 포인트를 시각화한 그림이다. 물리적으로 불가능한 조건을 제외한 310개 데이터는 빨간색 점으로 표시되었다.
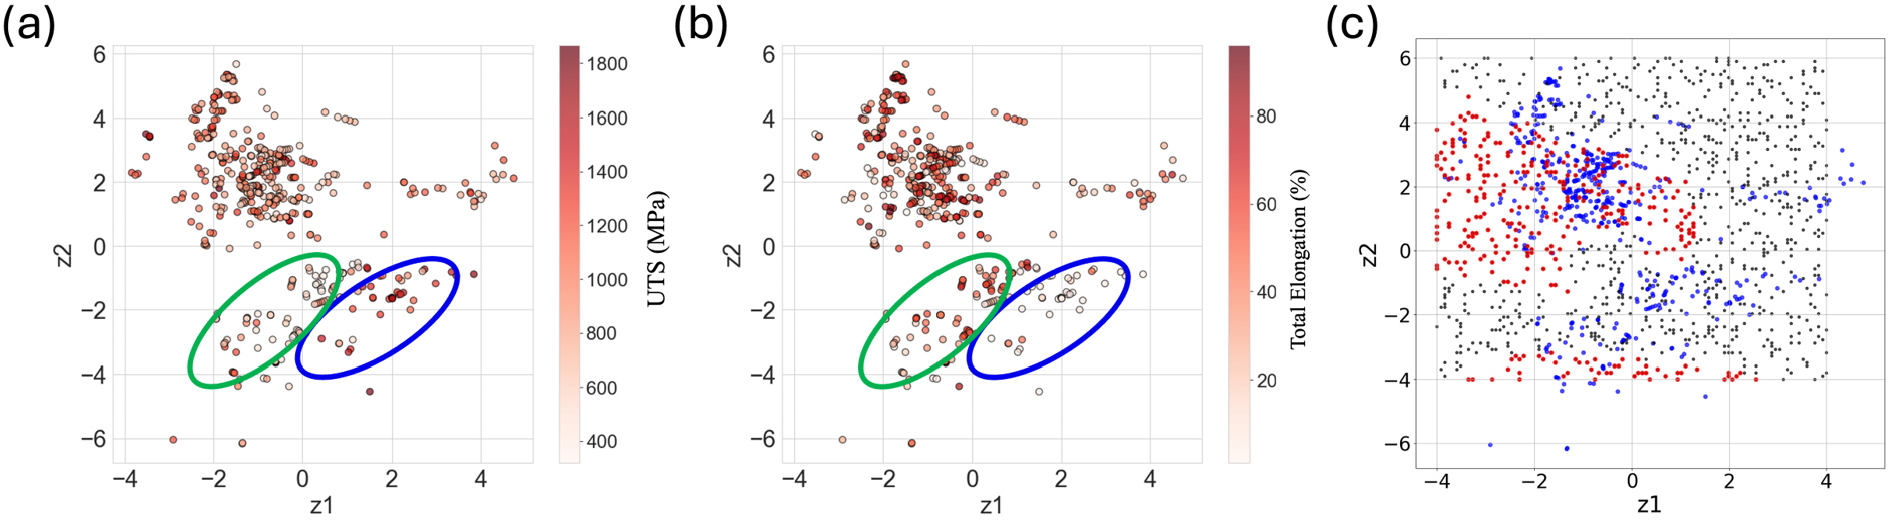
Fig. 8은 CVAE를 통해 생성된 데이터 중 물리적으로 구현이 불가능한 실험 조건을 제외하고 남은 310개의 데이터를 각 물성에 대해 학습된 XGBoost 모델을 통해 예측한 결과를 시각화한 것이다. 빨간색 점선은 각 물성의 평균을 나타낸다. 생성된 데이터 310개 중 17.7 %에 해당하는 55개의 데이터가 입력된 조건인 각 물성의 평균 이상을 만족한다. 이 결과를 통해 CVAE가 입력된 조건을 만족하는 데이터를 생성하였음을 알 수 있다.
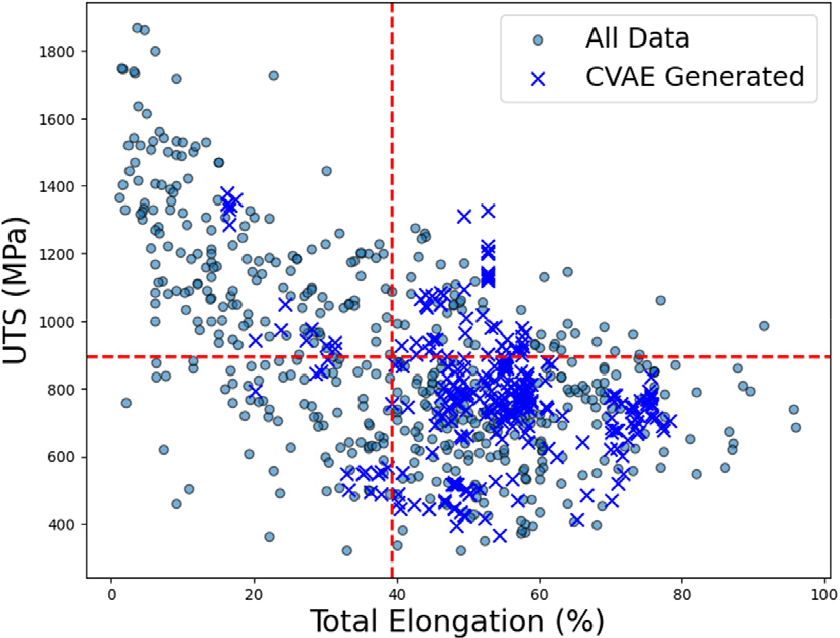
Fig. 9는 베이지안 최적화를 통해 추천된 후보들의 예측값과 최적화에 사용된 130개의 샘플을 시각화한 것이다. 회색으로 표시된 산점도는 501개 전체 데이터를 나타내며, 이에 대한 파레토 프론트는 회색 점선으로 표시되었다. 파란색으로 표시된 산점도는 베이지안 최적화 루프에 사용된 데이터이며 이에 대한 파레토 프론트는 파란색 실선으로 표시되었다. 베이지안 최적화를 통해 추천된 5개의 데이터 중에서 ⓐ, ⓑ, ⓒ는 파란색으로 표시되었다. 이들은 베이지안 최적화에 사용된 데이터의 파레토 프론트를 넘어서는 비지배 영역에 위치하여, 파레토 프론트 라인보다 우수한 다중 목적 성능을 만족한다. 이 중 ⓑ, ⓒ 두 개 데이터는 회색으로 표시된 전체 데이터의 파레토 프론트 라인 외부의 비지배 영역에 위치해, 베이지안 최적화를 통해 추천된 데이터가 기존 데이터를 업데이트하여 파레토 프론트를 확장할 잠재력이 있음을 시사한다.
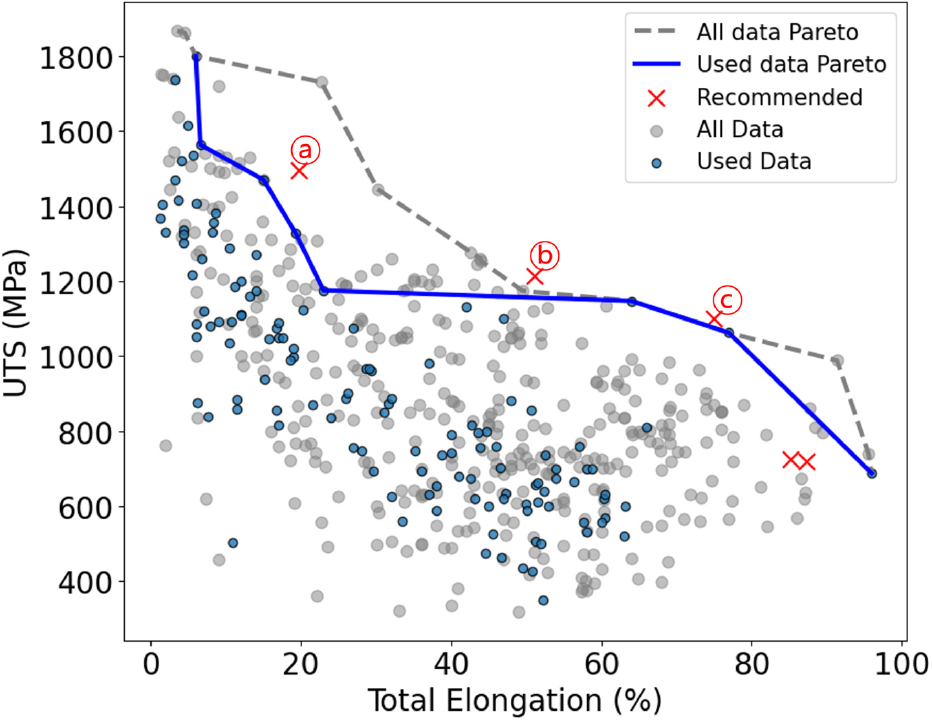
Fig. 10은 CVAE 모델을 통해서 생성된 데이터와 다중 목적 베이지안 최적화에 의해서 추천된 소재들에 대한 레이더 플롯으로, 각 소재에서 포함된 원소의 상대적 조성 비율을 나타낸 것이다. Fig. 10(a)는 Fig. 3(b)의 1사분면에 해당하는 CVAE의 생성에 사용된 데이터와 CVAE를 통해 생성된 310개 데이터에 대한 레이더 플롯이다. Fig. 10(b)는 베이지안 최적화 루프에 사용된 15 % 이상의 비율의 원소를 5개 이상 포함한 130개의 데이터에 대한 파레토 프론트에 해당하는 데이터와 베이지안 최적화를 통해 추천된 5개 데이터에 대한 레이더 플롯이다. Fig. 10(a)의 두 개의 데이터셋 조성분포가 거의 유사하며 Cr, Fe, Co, Ni가 모두 15 % 이상으로 두드러진 주요 원소로 나타난다. 이는 CVAE가 입력 조건의 조성 패턴을 충실히 학습하여 유사한 조성을 성공적으로 생성했음을 입증한다. 한편, Fig. 10(b)를 살펴보면 주황색 실선으로 표시된 파레토 프론트 조성과 파란색 실선으로 표시된 베이지안 최적화를 통해 추천된 데이터의 조성을 비교하면 Ni와 V 함량에서 차이를 보이지만 Co, Fe, Mn이 여전히 15 % 이상으로 유지되어 파레토 프론트 형태를 따르고 있음을 확인할 수 있다. 따라서 베이지안 최적화를 통해 제안한 조성은 기존 파레토 프론트 라인을 갱신하여 설계 공간을 확장할 잠재력을 가진 후보로 판단된다.
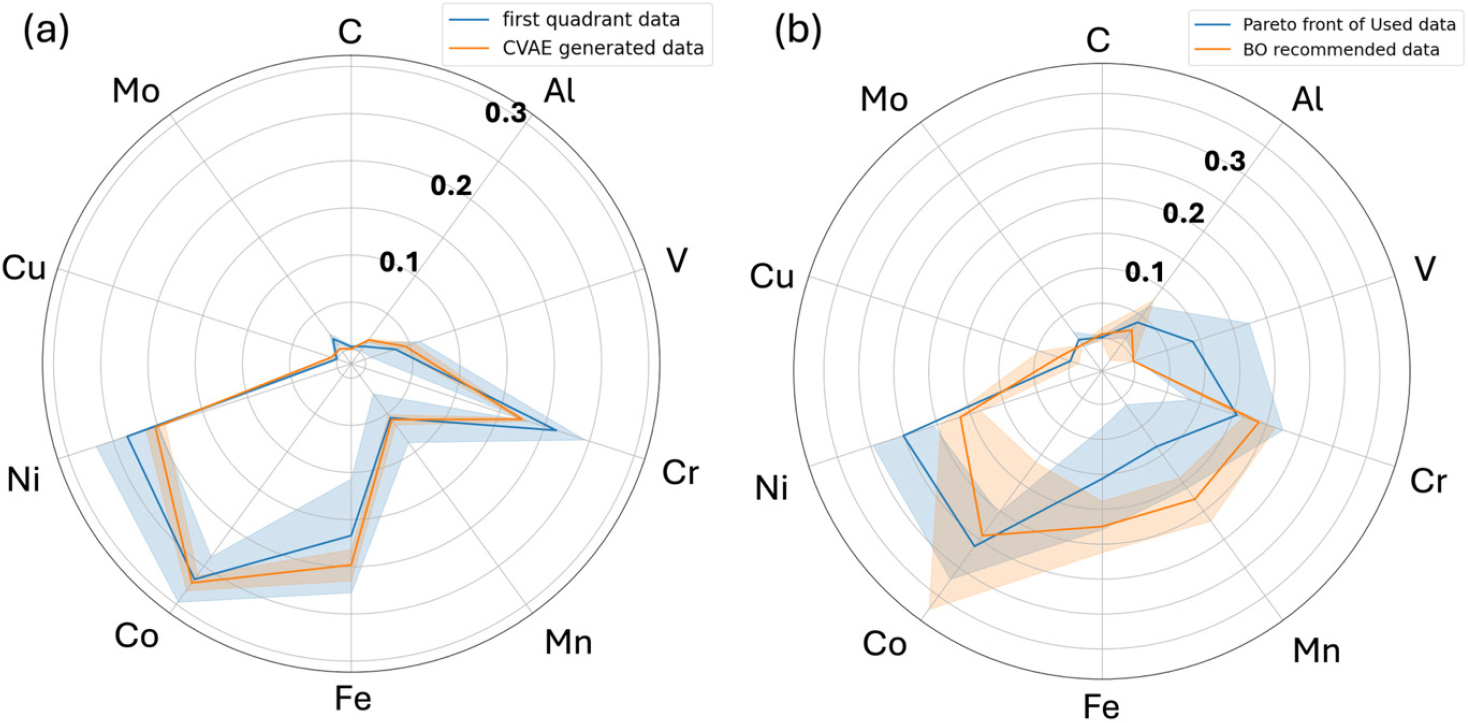
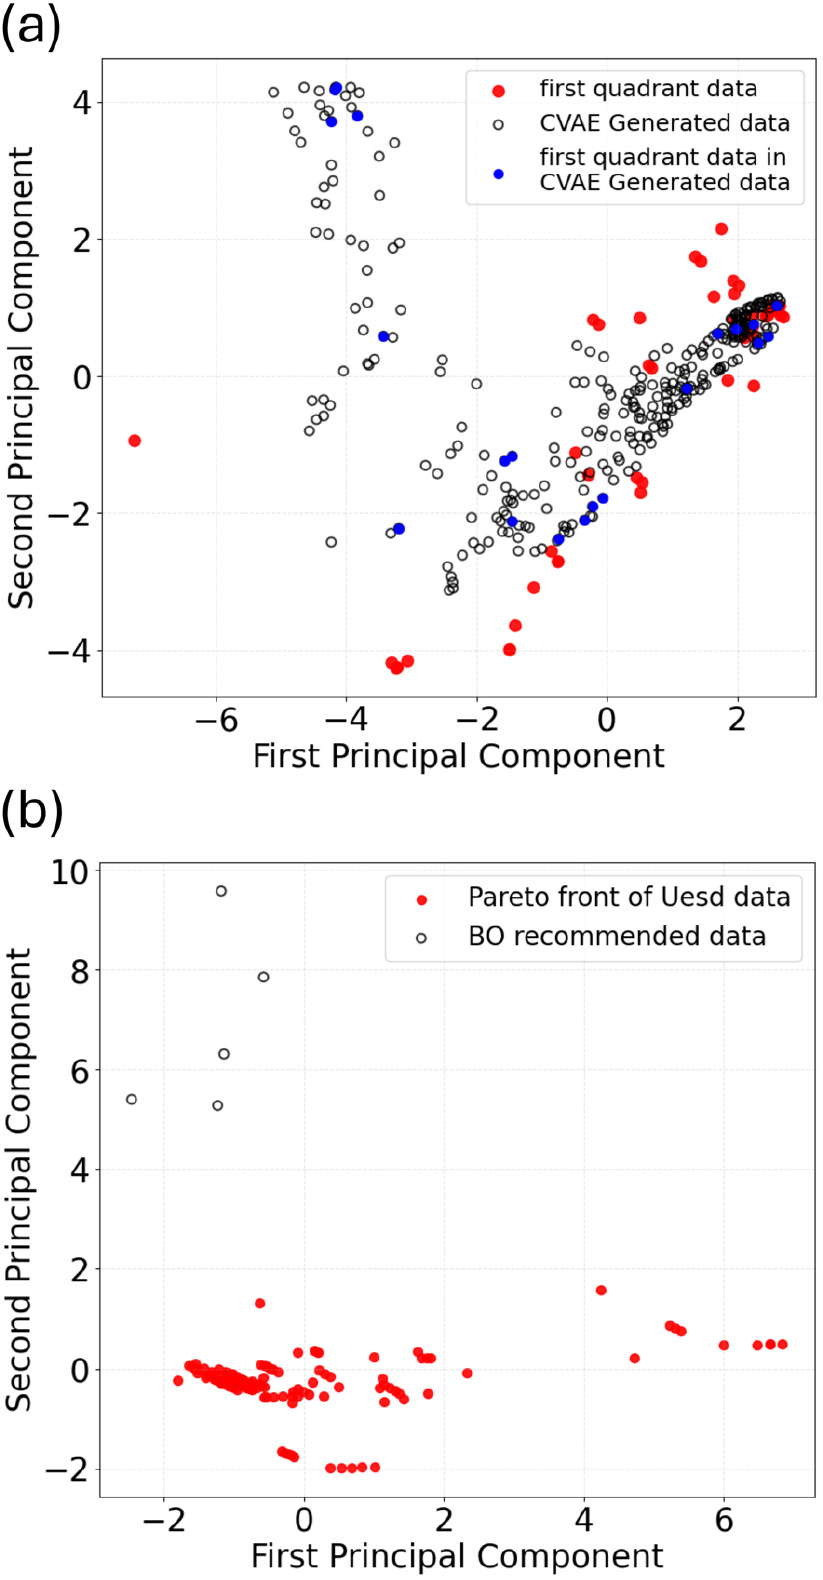
Fig. 11(a)는 차원 축소 기법인 주성분 분석(principal component analysis, PCA)를 이용하여 CVAE의 생성 조건으로 사용된 데이터와 CVAE를 통해 생성된 310개의 데이터를 함께 시각화한 것이다. 310개 데이터 중 CVAE에 입력한 조건에 부합하는 데이터는 파란색 산점도로 표시되었다. 파란색 산점도 중 상당수가 원본 데이터의 영역과 겹치는 것이 확인 가능하다. 또한, 회색 산점도로 표시된 CVAE의 생성 데이터의 영역이 빨간색으로 표시된 CVAE 조건 데이터의 영역과 상당수 겹쳐 있는 것을 확인할 수 있다. 따라서 CVAE를 통해 생성된 데이터가 CVAE 모델 학습에 사용된 조건의 데이터와 유사함을 보여준다. Fig. 11(b)는 베이지안 최적화에 사용된 130개의 학습 데이터와 베이지안 최적화를 통해 추천된 5개의 데이터를 PCA 방법으로 차원 축소하여 시각화한 것이다. 회색 산점도로 표시된 추천 데이터는 빨간색 원으로 나타낸 기존 학습 데이터 영역과 겹치지 않는데, 이는 베이지안 최적화 과정에서 대리모델의 불확실성이 큰 영역에서 추가 샘플을 제안했을 가능성을 시사한다. 이는 베이지안 최적화를 통해 기존 데이터의 분포와 유사한 후보뿐만 아니라, 기존 데이터와 차별화된 새로운 가능성을 지닌 후보 역시 탐색할 수 있음을 보여준다.
4. 결 론
본 연구에서는 최대 인장 강도와 총 연신율 두 가지 목표를 동시에 충족하는 HEA 조성을 추천하기 위해 CVAE 기반 소재 역설계와 EHVI 기반 다중 목적 베이지안 최적화 두 가지 접근법을 적용하고, 사전에 최적화한 XGBoost 모델로 예측 성능을 평가하였다. CVAE는 설정한 조건을 만족하는 다중 목적 후보군을 대량 생성해 탐색 범위를 넓혔으며, 베이지안 최적화는 기존 데이터 분포에서 불확실성이 높은 영역을 선별해 잠재적으로 다중 목적 성능을 개선할 가능성이 있는 5개의 조성을 제안하였다. 두 방법 모두 목표 특성 달성 가능성을 보였으나, 실험적 합성과 기계적 특성 검증이 필수적이며 이를 통해 모델 예측과 실제 성능 간의 정합성을 확인하는 것이 앞으로의 과제이다.