

1. 서 론
2. 실험 방법
2.1. 데이터셋 구성과 데이터 분석
2.2. 랜덤 포레스트 및 불확실성 분해와 분석 방법
2.3. 능동 학습 후보 선별 및 검증
3. 결과 및 고찰
4. 결 론
1. 서 론
네오디뮴-철-붕소(NdFeB) 소결자석은 현존하는 가장 강력한 영구자석으로, 전기차 구동모터, 풍력발전기, 각종 전자기기의 핵심 소재이다.1,2) 그중 보자력(coercivity, Hcj)은 자석이 외부 역자기장과 고온 환경에서 자화 상태를 유지하는 능력을 결정하는 핵심 물성으로, 조성과 공정뿐 아니라 결정립 크기・결정립계 상 분포와 같은 미세구조에 이르기까지 다양한 요인의 복합적 영향을 받는다.3,4) NdFeB 자석의 제조는 복잡하고 비용과 시간이 많이 소요되므로, 이러한 구조-물성 관계를 데이터 기반으로 규명하여 조성・공정 설계를 가속하려는 기계학습 연구가 활발히 진행되고 있다.5,6,7)
초기 연구들은 주로 선형 회귀, 서포트 벡터 머신, 랜덤 포레스트, 그래디언트 부스팅 등 전통적 기계학습 모델을 소규모 데이터에 적용하였다. 예를 들어 Qiao 등은 문헌에서 취합한 262개 데이터로 잔류자속밀도와 보자력을 예측하여 그래디언트 부스팅이 우수한 성능(보자력 R2 = 0.923)을 보임을 확인하였다.5) 나아가 Liang 등은 1,200여 개의 대규모 실험 데이터를 수집하고, 신경망에 다중 헤드 어텐션(multi-head attention) 메커니즘을 도입한 회귀 모델을 제안하여 잔류자속밀도와 보자력에 대해 각각 R2 = 0.97, 0.84의 예측 성능을 달성하는 한편, 어텐션 가중치와 샤플리 값(Shapley additive explanations, SHAP) 분석을 통해 조성・공정 변수가 물성에 미치는 영향을 해석하였다.6,8) 이처럼 최근 연구는 예측 정확도의 향상과 함께 조성・공정 요인의 기여를 규명하는 해석기반 도구를 추가하는 방면으로 확장되고 있다.
그러나 이러한 예측 모델이 실제 소재 개발에 활용되기 위해서는, 예측값 자체뿐 아니라 그 예측이 얼마나 신뢰할 수 있는지를 정량화하는 불확실성 정량화(uncertainty quantification)가 요구된다. 특히 학습 데이터가 포괄하지 못한 미지의 조성 영역에서 모델이 과도하게 신뢰(overconfidence)하는 잘못된 예측을 포함하는 위험을 사전에 진단하는 것이 중요하다. 소재정보학 분야에서는 이를 위해 다양한 불확실성 정량화 기법이 제안되어 왔다. Tran 등은 흡착 에너지 예측을 대상으로 정확도・보정(calibration)・예리함(sharpness)을 기준으로 여러 기법을 객관적으로 비교하는 평가 체계를 제시하였고,9) Li 등10)과 Zhou와 Yang11)은 베이지안 신경망(Bayesian neural network)을 통해 점 추정만 제공하는 기존 모델과 달리 예측 분포를 산출함으로써 미지 영역에서의 과도한 신뢰를 방지할 수 있음을 보였다.10,11) 이들 연구는 불확실성을 데이터 확충으로 줄일 수 있는 인식론적(epistemic) 성분과 본질적 노이즈에 해당하는 우연적(aleatoric) 성분으로 구분하고, 인식론적 불확실성이 높은 시료를 우선 선택하는 능동 학습(active learning)에 활용하였다. 즉, 불확실성 정량화는 단순히 예측 결과의 신뢰도를 평가하는 도구를 넘어, 모델이 충분히 학습하지 못한 영역을 식별하고 추가적인 실험 또는 데이터 수집의 우선순위를 결정함으로써 제한된 실험 자원을 효율적으로 활용하기 위한 능동 학습의 핵심적인 데이터 추천 기준으로 활용될 수 있다. 또한 Alvi 등은 계층적 심층 가우시안 과정(deep Gaussian process)에 사전지식을 결합하여 희소하고 이질적인 소재 데이터에서 물성 상관관계와 불확실성을 동시에 포착하는 접근을 제안하였다.12)
이처럼 불확실성 정량화는 고엔트로피 합금, 촉매, 크리프 수명 예측 등 여러 소재 분야에서 활발히 연구되어 왔으나, 정작 산업적 중요성이 큰 NdFeB 영구자석의 물성 예측에 이를 체계적으로 적용한 연구는 보고된 바가 거의 없다. 본 연구는 이러한 연구의 공백에 착안하여, 다수의 문헌에서 취합된 NdFeB 실험 데이터를 대상으로 랜덤 포레스트 기반의 불확실성 분해를 적용하고, 보자력 예측의 불확실성을 인식론적・우연적 성분으로 분해한다.5) 이를 통해 한 번도 학습에 사용되지 않은 미지 조성에 대한 외삽(extrapolation) 위험을 정량적으로 진단하고, 능동 학습 관점에서 데이터 효율이 높은 실험 후보를 선별하며, 데이터 자체의 품질과 라벨 일관성을 검증하고자 한다.
2. 실험 방법
2.1. 데이터셋 구성과 데이터 분석
본 연구에 사용한 데이터셋은 총 262개 시료로 구성되며,5) 각 시료는 21종의 원소 조성(wt%)과 소결・템퍼링 온도/시간, 분말 입도 등의 공정 변수, 그리고 목표 물성인 보자력(Hcj, 단위 kA・m-1)을 포함한다. 보자력은 SI 단위계인 kA・m-1로 표기하였다. 예측 모델의 입력 특징은 결측이 없는 수치형 변수 28개로 구성하였다. Fig. 1은 중희토류 첨가 원소인 Dy와 Tb에 대하여, 함량 구간별 보자력 분포를 바이올린-상자 그림으로 나타낸 것이다. 이는 두 원소 중 어느 쪽이 함량-물성 관계를 통계적으로 분석하고 외삽 실험의 기준 원소로 삼기에 적합한지를 데이터 관점에서 판단하기 위함이다. 모델이 학습 과정에서 특정 원소의 효과를 전혀 접하지 못하도록, Dy를 기준 원소로 선택하여 Dy를 포함하지 않는 시료(137개)를 학습셋으로, Dy를 포함하는 시료(125개)를 시험셋으로 분할하였다. 이 설계에서 모델은 미지의 Dy 함유 조성에 대한 외삽 예측을 수행하게 되며, 이를 통해 외삽 상황에서의 예측 신뢰도를 정량적으로 평가할 수 있다.
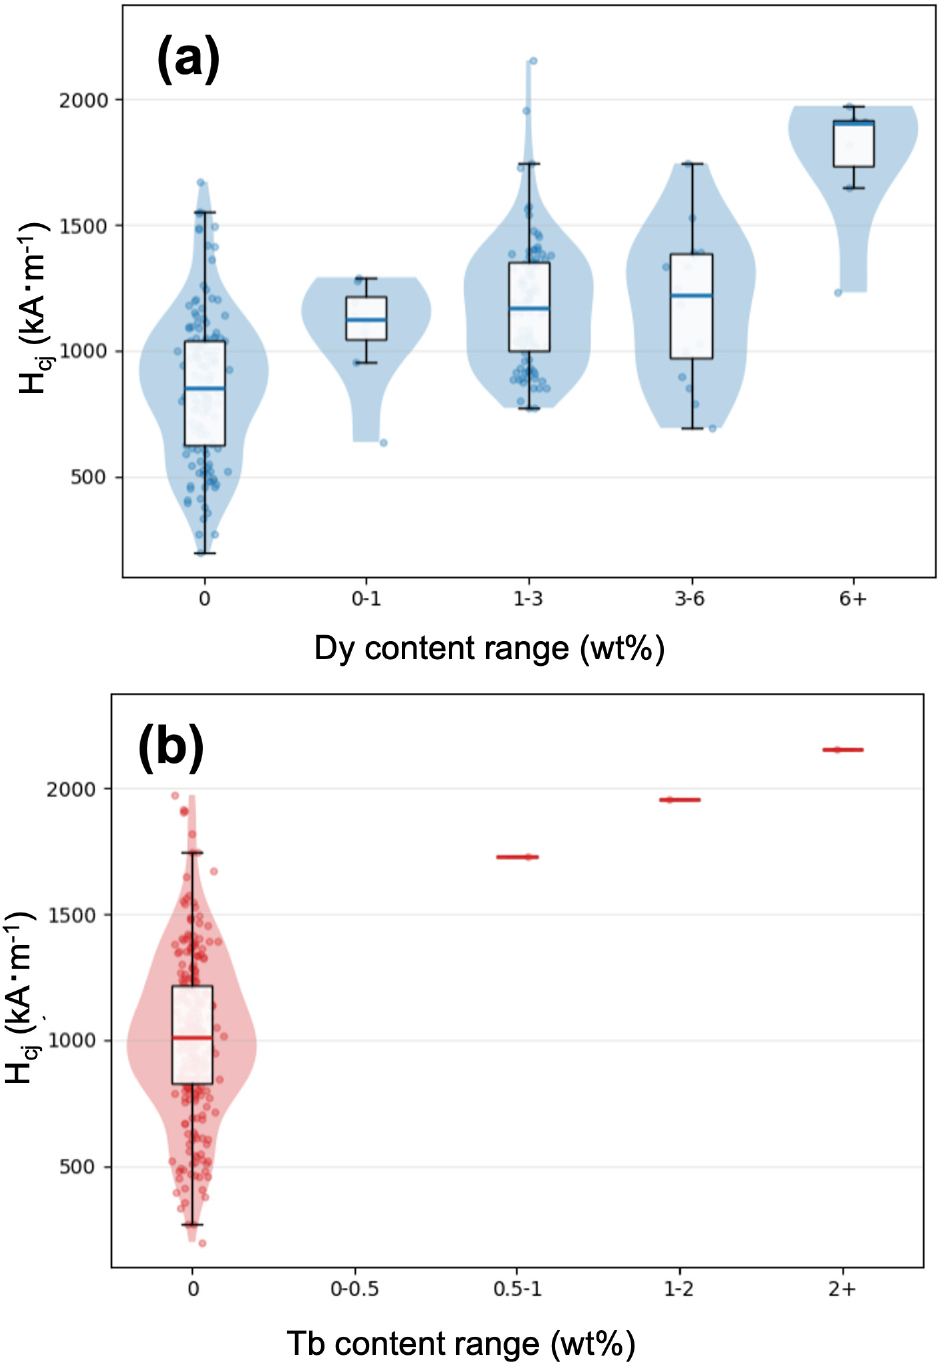
Fig. 1.
Distribution of intrinsic coercivity (Hcj) as a function of heavy rare-earth content, shown as combined violin and box plots. (a) Dysprosium (Dy) content and (b) terbium (Tb) content, each grouped into concentration ranges (wt%). Individual points denote experimental samples. Dy is distributed across all concentration ranges (n = 137, 8, 94, 16, and 7 for the 0, 0-1, 1-3, 3-6, and 6+ wt% bins, respectively), whereas Tb-containing samples are extremely scarce (n = 1 in each non-zero bin), indicating that Dy provides sufficient compositional diversity for quantitative structure-property analysis.
2.2. 랜덤 포레스트 및 불확실성 분해와 분석 방법
랜덤 포레스트 회귀 모델(트리 100개, max_features = 0.1)을 학습한 뒤, 100개 개별 트리의 예측을 각각 수집하여 분산 보존 원리에 따라 다음 세 가지 불확실성을 계산하였다. 전체 불확실성(total)은 실제값과 각 트리 예측 간의 평균제곱오차 식 (1)로 정의하고, 인식론적 불확실성(epistemic, Epi)은 트리 평균값 기준의 예측 분산 식 (2)로 정의하며, 우연적 불확실성(aleatoric, Ale)은 두 값의 차이 σAle2 = σ2 - σEpi2로 산출하였다. 인식론적 불확실성은 데이터 확충으로 줄일 수 있는 성분이며, 우연적 불확실성은 데이터의 본질적 노이즈로 간주되는 성분이다. 식 (1)과 (2)에서 n, , , 는 각각 전체 데이터 수, 예측값, 평균값, 실제값을 나타낸다.
2.3. 능동 학습 후보 선별 및 검증
인식론적 불확실성이 높고(상위 25 %) 우연적 불확실성이 낮은(하위 25 %) 시료를 다음 실험의 유망 후보로 정의하고, 획득 점수(acquisition score = epistemic/aleatoric)로 순위를 매겼다. 나아가 이 후보 선정 기준의 타당성을 직접 검증하기 위하여, 정확히 예측된 저Dy 후보 시료(row 137)와 크게 빗나간 고Dy 시료(row 189)를 각각 학습셋에 1개씩 추가한 뒤 시험 성능 변화를 비교하였다. 공정한 비교를 위해 추가된 시료는 시험셋에서 제외하고 동일한 축소 시험셋에서 평가하였다. 불확실성의 원인을 규명하기 위해, 대표 시료들에 대한 100개 트리의 예측 분포를 바이올린 그림과 히스토그램으로 시각화하고, 전체 시험셋에 대한 트리 간 분산과 실제 예측 오차의 관계를 분석하였다. 또한 동일하거나 근접한 조성이 서로 다른 보자력을 갖는 정도를 정량화하여, 관측된 우연적 불확실성이 실제 데이터 노이즈에서 기인하는지 아니면 모델의 외삽 편향에서 기인하는지를 검증하였다.
3. 결과 및 고찰
Dy와 Tb의 함량 구간별 보자력 분포를 비교한 결과, 두 원소 모두 함량이 증가할수록 보자력이 상승하는 경향을 Fig. 1에서 확인할 수 있다. 그러나 데이터의 분포 구조는 크게 달랐다. Fig. 1(a)에서 볼 수 있는 것처럼, Dy는 0, 0-1, 1-3, 3-6, 6+ wt%의 여러 함량 구간에 걸쳐 시료가 고르게 분포(각 구간 n = 137, 8, 94, 16, 7)하여 함량-보자력 관계를 통계적으로 분석하기에 충분한 다양성을 확보하였다. 구간별 평균 보자력은 859 (Dy 없음)에서 1,772 kA・m-1 (6+ wt%)까지 단조 증가하였다. 반면 Tb는 첨가 시료가 극소수(비영 구간 각 n = 1)에 불과하여 함량 효과를 신뢰성 있게 규명하기 어려움을 Fig. 1(b)에서 확인할 수 있다. 따라서 본 데이터셋에서 중희토류의 특성 기여와 저감 전략을 정량적으로 다루기에는 Dy가 Tb보다 적합한 분석 대상이며, 이는 이후 Dy를 외삽 실험의 기준 원소로 선정한 근거가 된다.
Dy 미포함 시료를 포함한 데이터를 학습 데이터로 정의하고, Dy를 포함하는 데이터를 테스트 데이터로 정의한다. 학습 데이터에서 회귀 예측 성능인 결정계수는 다음과 같이 R2 = 0.965의 우수한 예측 성능을 보이는 것을 Fig. 2(a)에서 볼 수 있다. 테스트 데이터에서는 회귀 예측 성능 R2 = -0.994로 완전히 붕괴하였다. Fig. 2(b)의 회귀 예측 성능(parity plot)을 보면 테스트 데이터의 예측값은 실제 보자력이 1,500-2,100 kA・m-1에 이르는 고성능 시료를 전혀 포착하지 못하고 700-1,100 부근에 과소예측(under-predicted)을 보이며, 오차막대 또한 크게 확대되었다. 이는 소결 NdFeB 영구자석에서 Dy가 보자력을 크게 향상시키는 효과를 모델이 학습하지 못했기 때문이다.
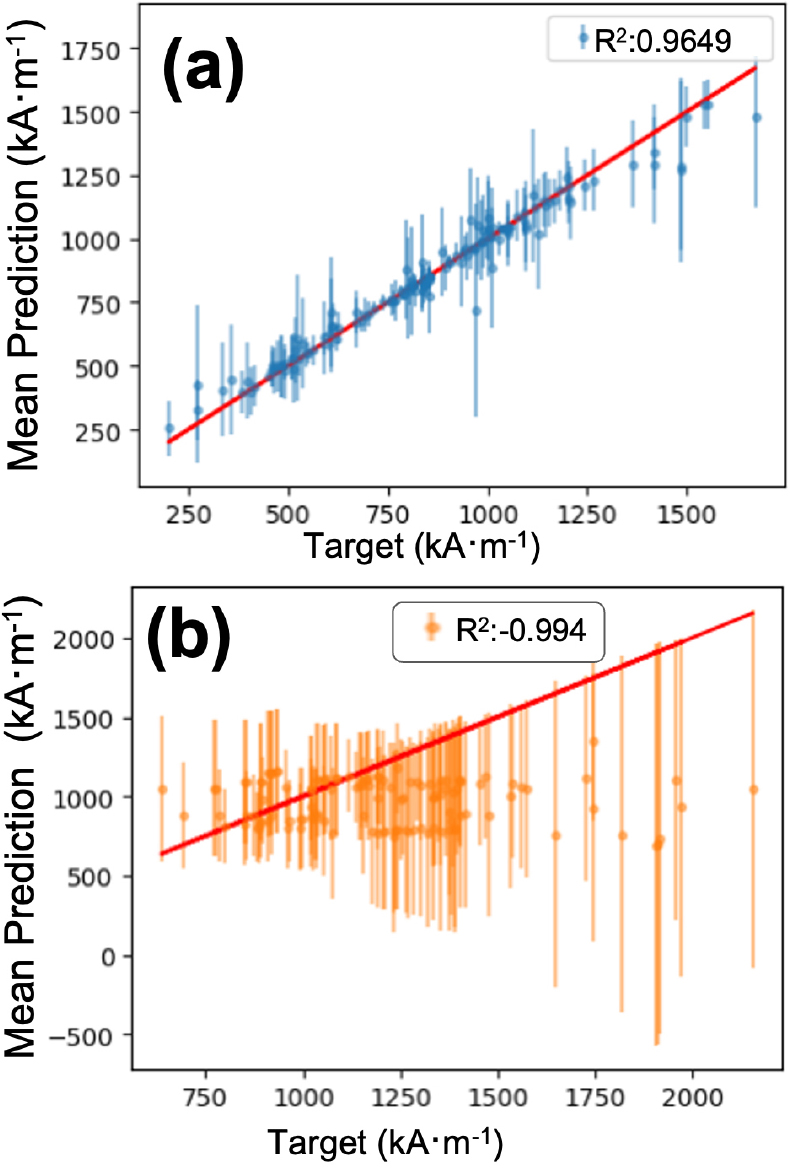
Fig. 2.
Parity plots of the random-forest model with error bars representing the total predictive uncertainty (one standard deviation). (a) Training set (Dy-free samples), coefficient of determination R2 = 0.965; (b) test set (Dy-containing samples), R2 = -0.994. The solid line denotes the ideal parity.
Fig. 3은 불확실성 분해 결과를 학습 데이터와 테스트 데이터에 각각 나타낸 것으로 위 패널은 학습 데이터에서 나타낸 것이고 아래 패널은 테스트 데이터에 대해서 각각 나타낸 것이다. Fig. 3의 x축은 각 시료에 대해 랜덤 포레스트 분산 분해로 계산된 총 예측 불확실성 및 그 인식론적・우연적 성분의 분산값을 나타내며, 학습 및 테스트 데이터의 불확실성 크기 차이를 고려하여 각각 ×104와 ×106의 서로 다른 축척으로 표시하였다. 각 패널에서 왼쪽부터 전체, 인식론적, 우연적 불확실성을 차례대로 나타내었다. 테스트 데이터의 전체 불확실성 평균은 240,321로 학습 데이터(16,509) 대비 약 15배 규모로 급증하였다. 이때 인식론적 불확실성은 학습 데이터 값(13,503)에서 테스트 데이터 값(73,534)으로 약 5.45배 증가하였다. 반면에, 우연적 불확실성은 학습 데이터 값(3,006)에서 테스트 데이터 값(166,787)으로 55배 이상 크게 증가하였다. 즉 전체 불확실성 증가분의 대부분이 우연적 성분으로 나타났는데, 이는 뒤에서 설명하겠지만, 실제 데이터 노이즈로 해석하기보다는 외삽 편향이 분산 분해 과정에서 흡수된 결과로 이해된다.
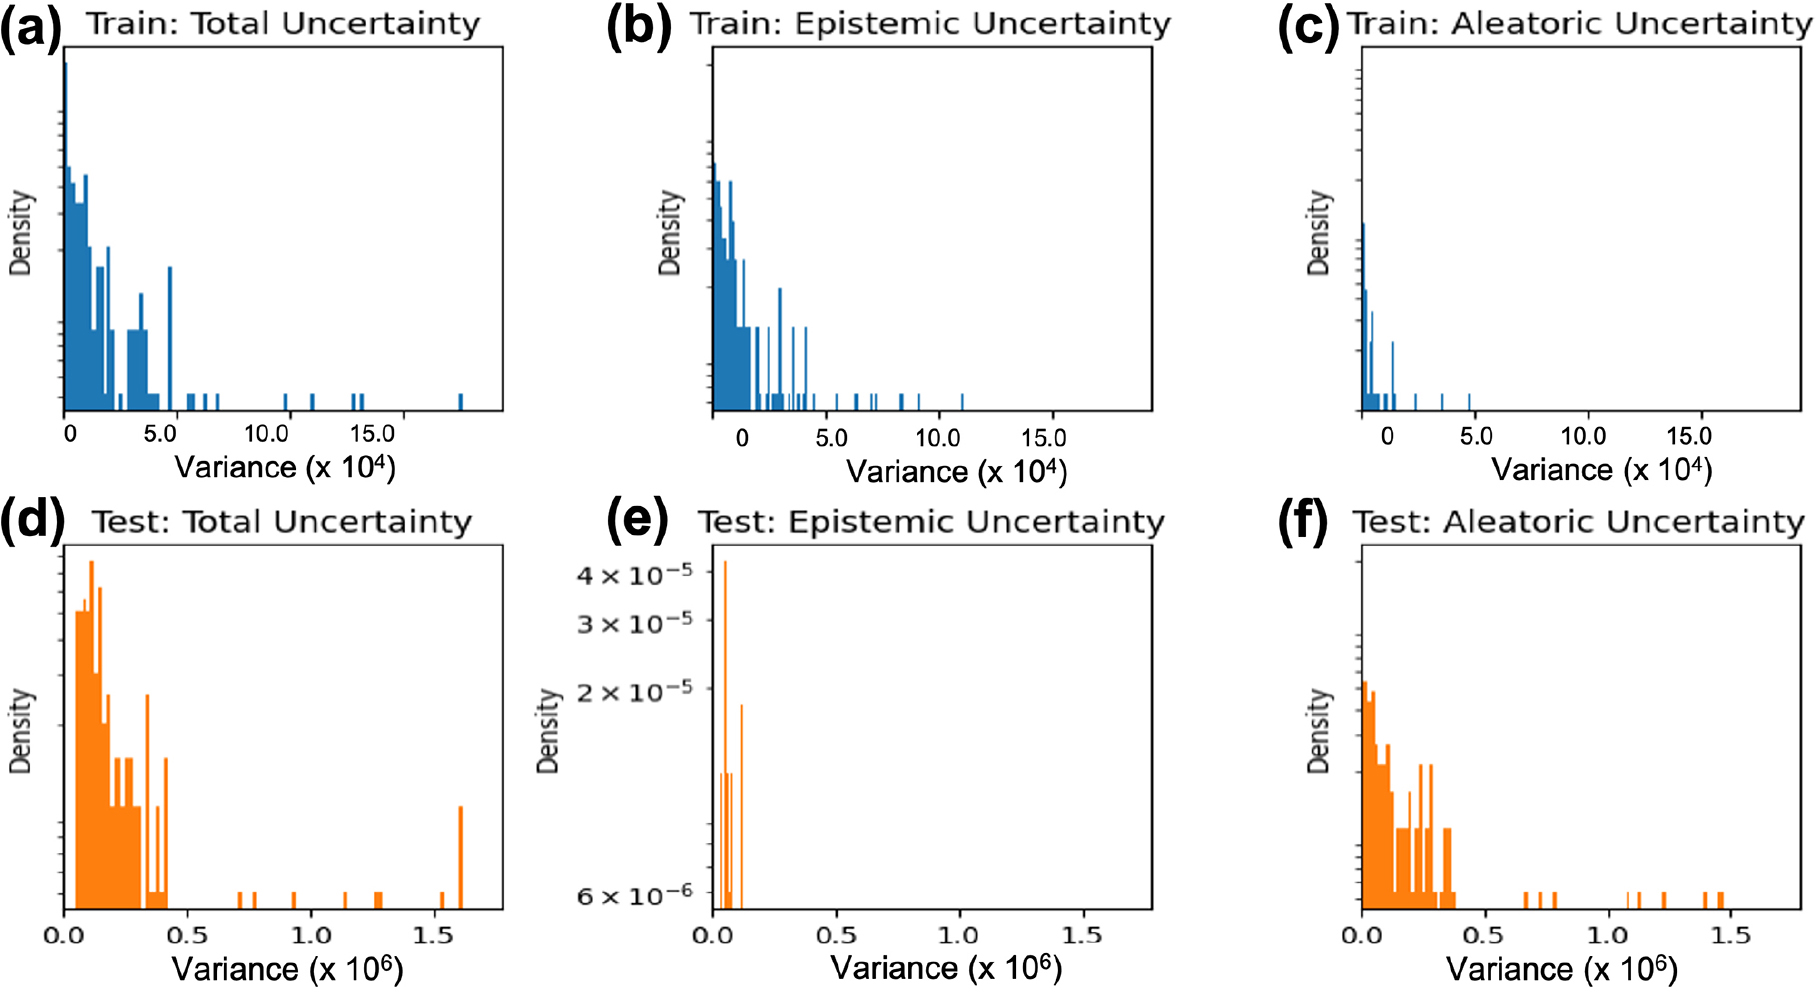
Fig. 3.
Histograms of the decomposed predictive uncertainties obtained from the random-forest variance decomposition. (a-c) Training set: total, epistemic, and aleatoric variance; (d-f) test set: total, epistemic, and aleatoric variance. Note the differing horizontal scales (×104 for the training set, ×106 for the test set): the total test-set uncertainty increases roughly fifteen-fold relative to training, with the increase dominated by the aleatoric component.
Fig. 4는 인식론적 불확실성과 우연적 불확실성의 관계를 나타낸 것이다. Fig. 4의 x축에는 인식론적 불확실성, y축은 우연적 불확실성을 나타냄으로써 두 가지 서로 다른 불확실성의 관계를 확인할 수 있다. 학습 데이터에서는 두 성분이 양의 상관을 보이며 대각선으로 분포하는 반면, 테스트 데이터에서는 인식론적 불확실성이 좁은 범위에 몰리고 우연적 불확실성이 넓게 퍼지는 상이한 구조를 나타냈다. 인식론적 불확실성이 높고(상위 25 %, > 96,150) 우연적 불확실성이 낮은(하위 25 %, < 7,522) 시료를 유망 후보로 선정한 결과를 획득 지도로 하여 Fig. 5에 나타내었다. Fig. 5의 오른쪽 아래 영역에서 11개 시료가 능동 학습에 필요한 유망 후보로 선별되었다. 11개 시료는 모두 Dy를 약 1.2 wt% 포함한 낮은 Dy 조성값을 갖는 계열에 집중되었으며, Dy를 포함하지 않는 학습 데이터와 가장 인접한 경계 영역에 해당한다.
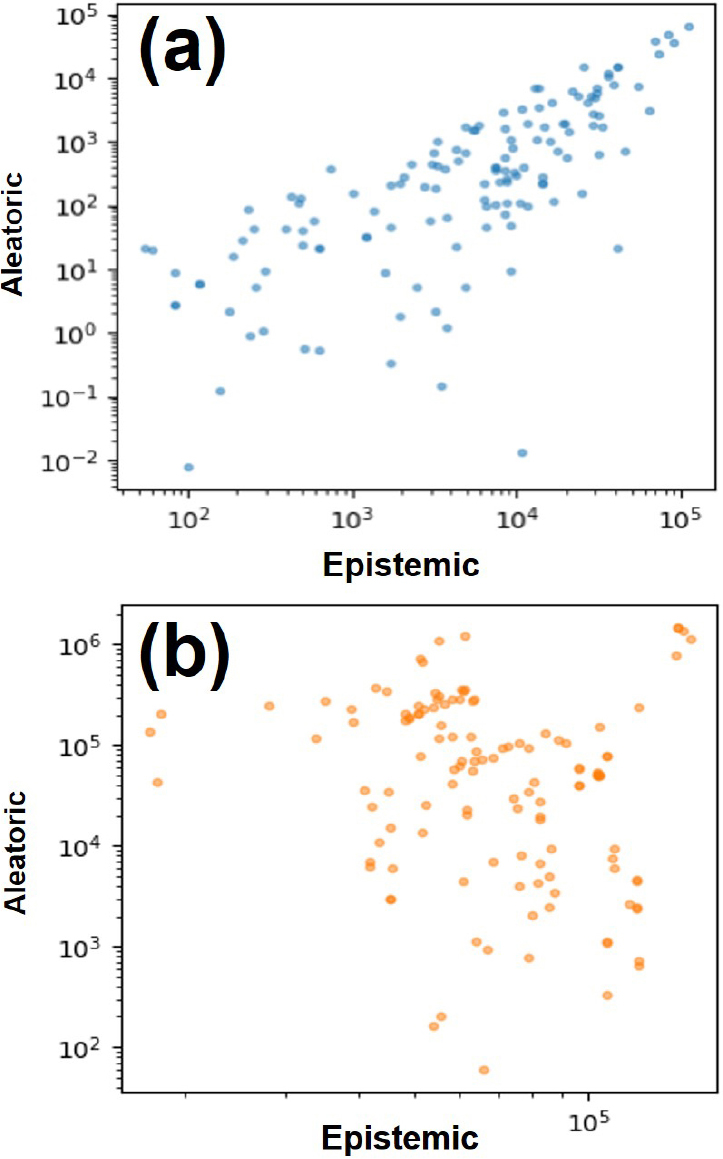
Fig. 4.
Relationship between epistemic and aleatoric uncertainty on a log-log scale for (a) the training set and (b) the test set. In the training set the two components are positively correlated, whereas in the test set the epistemic uncertainty is confined to a narrow range while the aleatoric component spreads widely, reflecting the distinct behavior of the uncertainty decomposition under compositional extrapolation.
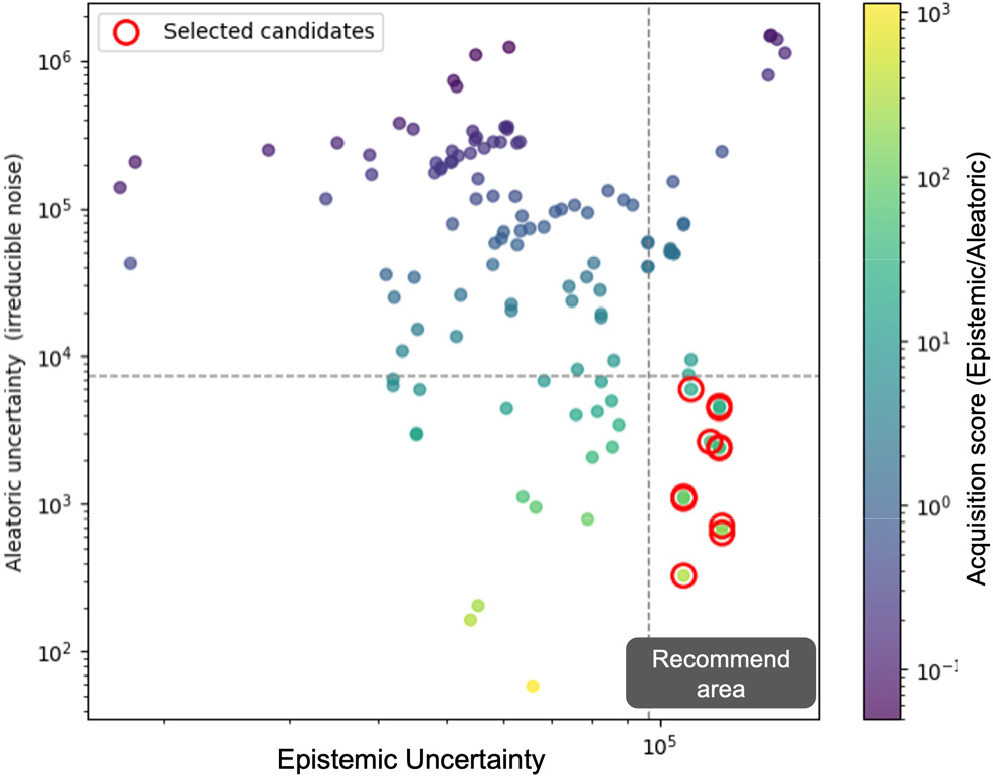
Fig. 5.
Acquisition map for next-experiment candidate selection. Each point represents a Dy-containing test sample, positioned by its epistemic (horizontal) and aleatoric (vertical) uncertainty and colored by the acquisition score (epistemic/aleatoric). The eleven selected candidates (red circles) fall within the recommended area of high epistemic and low aleatoric uncertainty (bottom-right), and all cluster in the low-Dy compositional family.
위 획득 점수 기준의 타당성을 직접 검증하기 위해, 정확히 예측된 저Dy 후보와 크게 빗나간 고Dy 시료를 각각 학습셋에 추가하고 시험 성능 변화를 비교하여 Fig. 6에 나타내었다. Fig. 6에서 위 패널은 학습 데이터에 대한 것이며, 아래 패널은 테스트 데이터에 대한 회귀 예측 성능의 변화를 보여준다. Fig. 6(a, d)는 데이터를 추가하기 전의 결과이며, Fig. 6(b, e)는 저Dy 후보, Fig. 6(c, f)는 고Dy 후보를 각각 추가하였을 때의 변화를 나타낸 것이다. 획득 점수상 ‘최적 후보’였던 저Dy 시료를 추가해도 시험 성능은 거의 개선되지 않은 반면(R2: -0.994 → -0.965, ∆R2 = +0.029), ‘피해야 할’ 시료로 분류되었던 고Dy 시료를 추가하였을 때 시험 성능이 크게 향상되었다(R2: -0.994 → -0.487, ∆R2 = +0.508). 이러한 결과는 저Dy 후보가 이미 모델이 잘 예측하는 영역이어서 추가 정보량이 적은 반면, 고Dy 시료는 모델이 전혀 학습하지 못한 ‘고Dy → 고보자력’ 관계를 담고 있어 단 하나의 추가만으로도 유사 조성들의 예측을 개선하기 때문으로 해석된다. Fig. 6(c)의 데이터가 추가된 학습 데이터의 회귀 예측 성능에서 고Dy 시료(별표, 실제 값: 약 1,900 kA・m-1)가 학습에 포함된 뒤에도 대각선에서 크게 벗어나 예측되고 있다. 이것은, 랜덤 포레스트 모델이 트리 평균을 통하여 예측값이 결정되기 때문에 하나의 극단적인 값을 완전히 학습하지 못함을 보여준다. 그럼에도 새로운 테스트 데이터에서 고보자력 점들이 대각선 쪽으로 당겨져 올라오는 개선이 관측되는 것은 추가된 고Dy 시료의 값이 학습이 되었기 때문으로 이해되며, 이것은 Fig. 6(f)에서 확인할 수 있다.
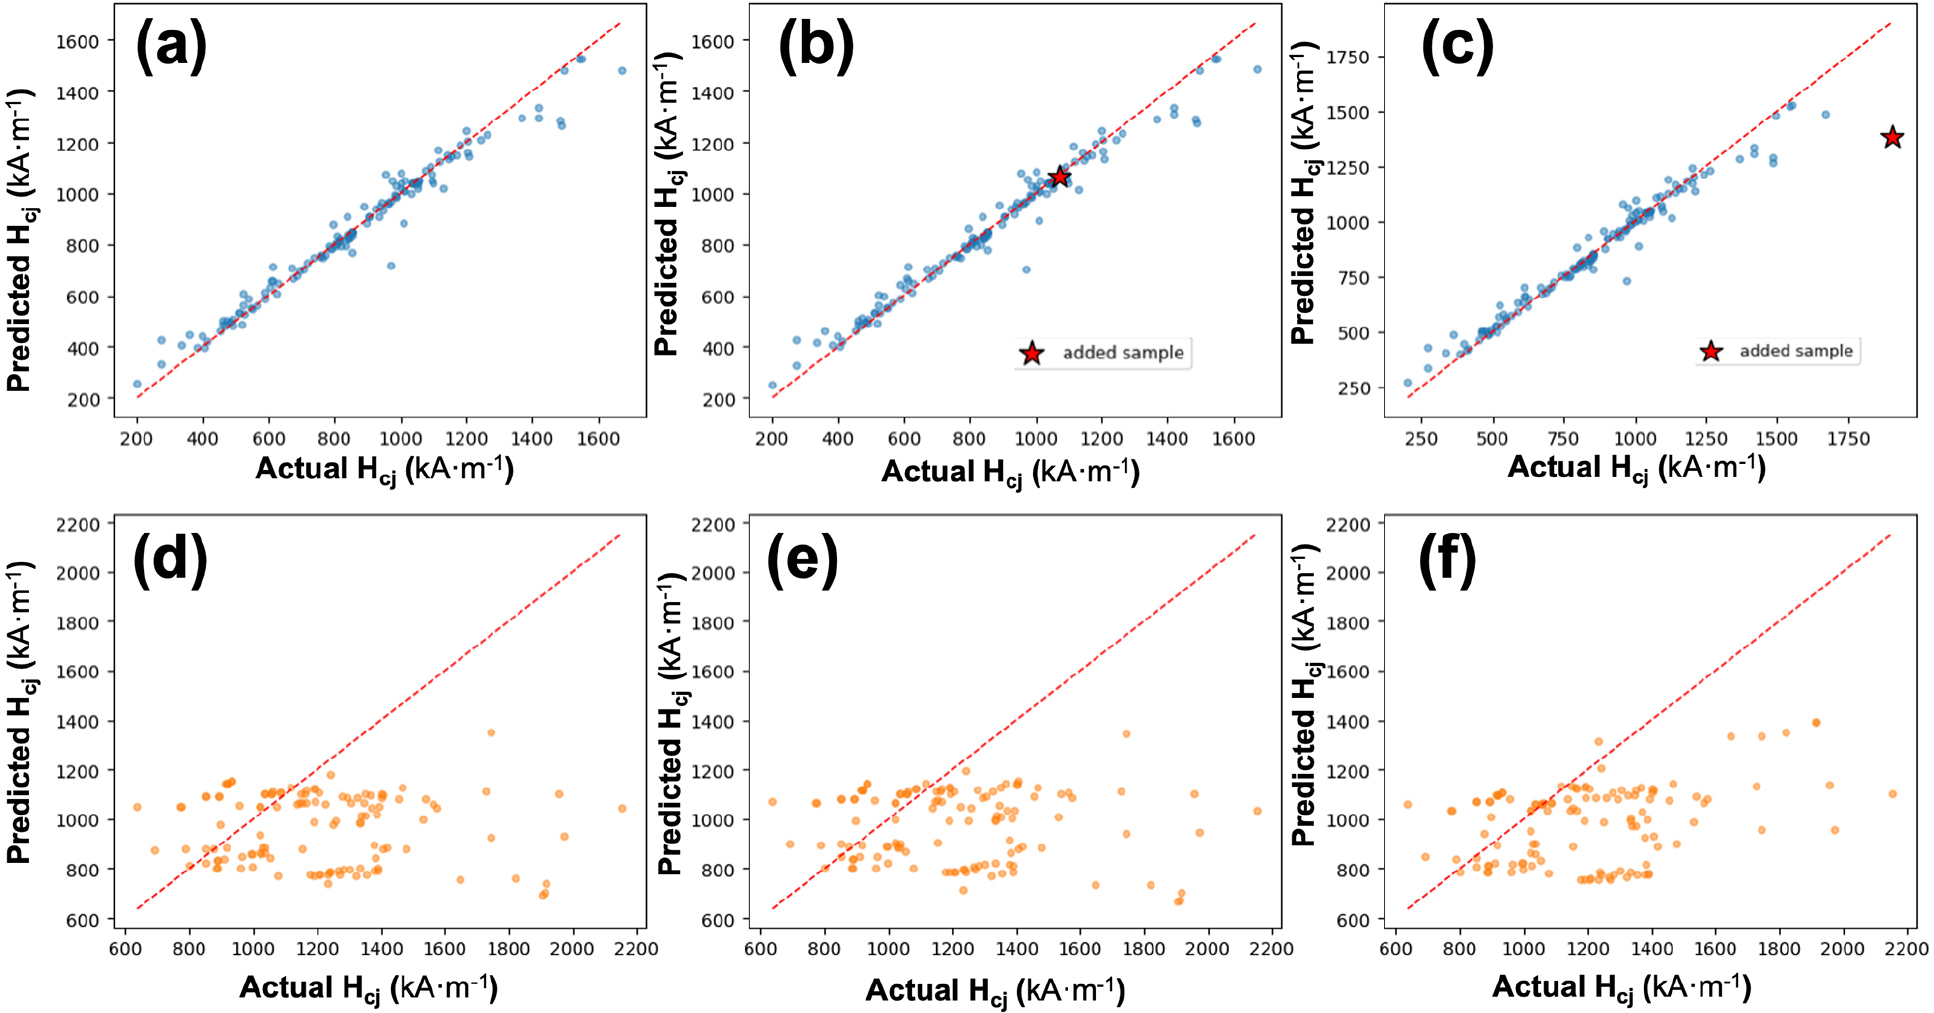
Fig. 6.
Effect of adding a single sample to the training set on regression performance. Columns correspond to the baseline (a, d) for no addition, (b, e) for addition of a low-Dy candidate, and (c, f) for addition of a high-Dy sample; the added sample is marked by a red star. Adding the low-Dy candidate leaves test performance essentially unchanged (∆R2 = +0.029), whereas adding the high-Dy sample substantially improves it (∆R2 = +0.508), pulling the high-coercivity predictions toward the parity line.
Fig. 7은 랜덤 포레스트 모델의 하이퍼 파라미터에서 설정한 100개 트리의 예측 분포를 정밀 분석한 결과를 보여준다. 저Dy가 포함된 시료와 고Dy가 포함된 시료의 예측값의 분포와 실제값은 Fig. 7(a, b)에 각각 나타내었다. 그 중에서, 정확히 예측된 후보 시료(low-Dy #1: 실제 1,070.6 kA・m-1, 예측 1,052.5 kA・m-1, 오차 18.1 kA・m-1)와 크게 빗나간 시료(high-Dy #1: 실제 1,906.0 kA・m-1, 예측 691.7 kA・m-1, 오차 1,214.3 kA・m-1)의 트리 간 분산이 유사한 규모로 나타남을 Fig. 7(a, b)를 통해서 알 수 있다. 두 경우 모두 트리들은 약 270-1,670 kA・m-1 의 동일한 범위에서 분산되어 예측하였으나, high-Dy #1 시료의 실제값은 어떤 트리도 도달하지 못한 영역에 위치하고 있음을 Fig. 7(d)에서 확인할 수 있다. 이는 high-Dy 시료에서 나타난 큰 예측 오차가 단순한 데이터의 우연적 변동보다는 학습 데이터에서 충분히 대표되지 않은 Dy 조성 영역에 대한 모델의 체계적인 편향과 관련되어 있음을 시사한다.13) 이러한 해석을 검증하기 위해, 정확히 예측된 low-Dy #1 시료와 크게 벗어난 high-Dy #1 시료를 각각 학습 데이터에 추가한 후 모델 성능 변화를 비교하여 Table 1에 나타내었다. 공정한 비교를 위해 추가된 시료는 모두 테스트 세트에서 제외하고 동일한 축소 테스트 세트에서 평가하였다. 이미 정확하게 예측된 low-Dy #1 시료를 추가한 경우 테스트 성능의 변화는 미미하였으나(∆R2 = +0.029), 기존 모델에서 크게 벗어난 high-Dy #1 시료를 추가한 경우 테스트 R2가 -0.995에서 -0.487로 크게 개선되었다(∆R2 = +0.508). 이는 high- Dy 영역에서의 예측 실패가 단순한 데이터 노이즈보다는 해당 조성 영역의 학습 데이터 부족으로 인한 모델 편향과 관련되어 있음을 뒷받침한다.
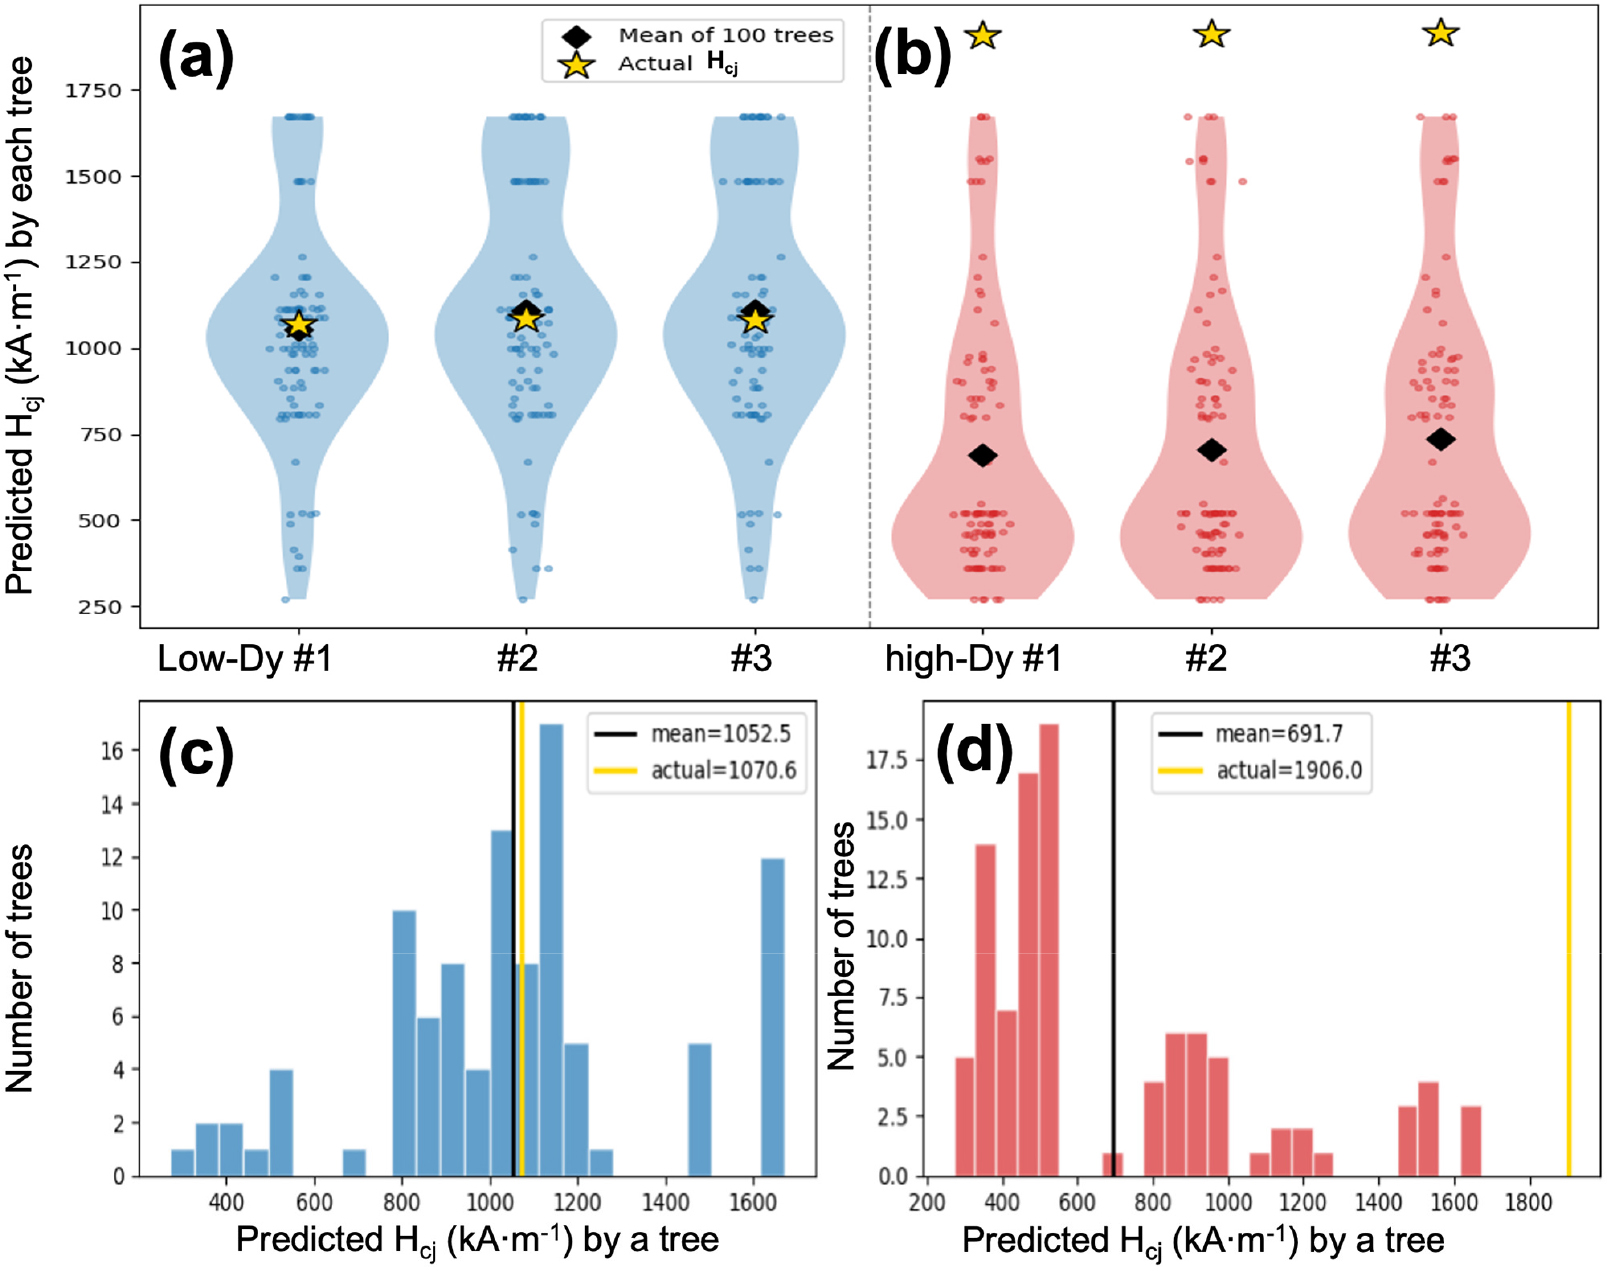
Fig. 7.
Distribution of the 100 individual tree predictions for representative samples. (a, b) Violin plots for three low-Dy candidates (Dy ≈ 1.19 wt%) and three high-Dy samples (Dy ≈ 15.94 wt%); gold stars mark the actual Hcj and black diamonds the mean of the 100 trees. (c, d) Histograms of the tree predictions for a representative low-Dy candidate (actual 1,070.6 kA・m-1, mean 1,052.5) and a high-Dy sample (actual 1,906.0 kA・m-1, mean 691.7).
Table 1.
Effect of adding one sample to the training set: a low-Dy candidate (row 137) or a high-Dy sample (row 189). The added sample was excluded from the test set, and both scenarios used the same reduced test set. R2, MAE (kA・m-1), and ΔR2 indicate the coefficient of determination, mean absolute error, and change in test R² from the baseline, respectively. Adding the favorable low-Dy candidate had little effect, whereas the unfavorable high-Dy sample substantially improved performance.
전체 테스트 데이터에 대해서도 트리 간 불일치도와 실제 예측 오차 사이의 상관은 뚜렷하지 않음을 Fig. 8을 통해서 확인할 수 있다. 여기서 랜덤 포레스트 모델 내부의 트리 간 불일치도는 인식론적 불확실성으로 이해할 수 있다. 트리 분산이 작은 구간에도 큰 오차를 가진 시료가 섞여 있어, 극단적인 데이터의 외삽 상황에서는 트리 간 합의정도로 예측 신뢰도를 판단할 수 없음을 확인하였다. 이 결과는 Fig. 6의 검증과 일관되며, 단순 분산 차감 방식의 획득 점수가 본 데이터셋의 능동 학습 후보 선정 지표로는 부적절할 수 있음을 뒷받침한다.
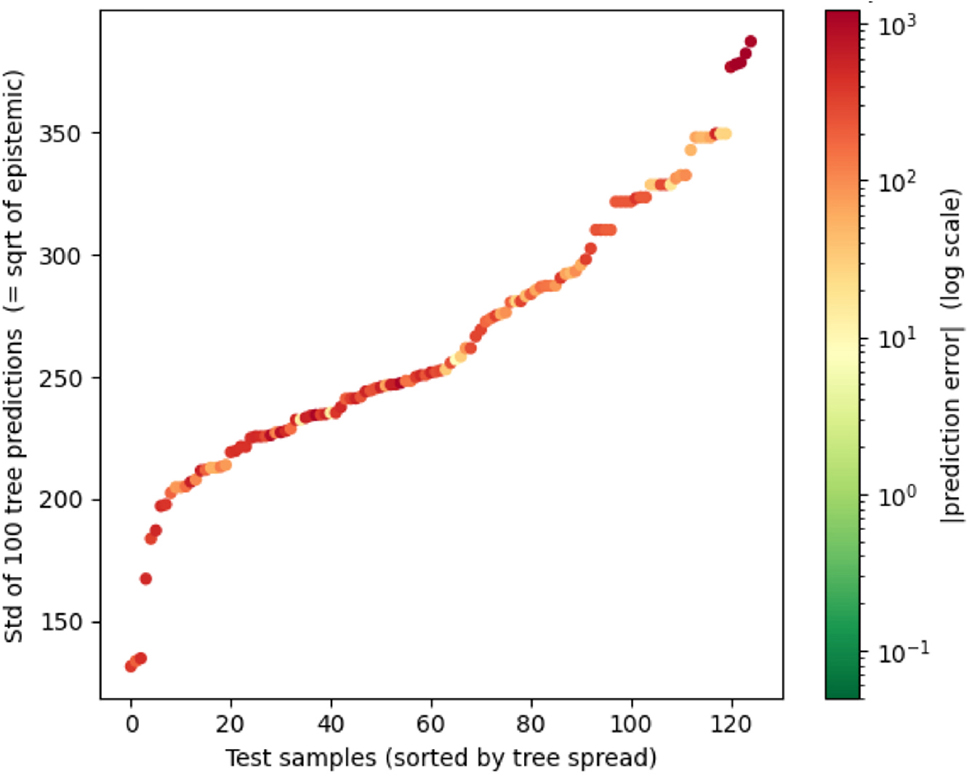
Fig. 8.
Tree-to-tree disagreement across all 125 Dy-containing test samples, sorted by tree spread. The vertical axis shows the standard deviation of the 100 tree predictions (the square root of the epistemic uncertainty), and points are colored by the absolute prediction error on a logarithmic scale.
Fig. 9는 분산 분해를 통해서 알게 된 우연적 불확실성이 실제 데이터 노이즈에서 기인하는지를 검증하기 위한 것이다. 먼저 조성이 동일한 반복 조성 36개를 분석한 결과, 보자력 변동 범위가 최대 700.5 kA・m-1, 평균 119.8 kA・m-1 값에 이르는 것을 Fig. 9(a)를 통해서 확인할 수 있다. 근접 입력 쌍 분석에서도 입력 거리가 매우 작음에도 보자력이 수백 kA・m-1 차이 나는 사례가 다수 관측됨을 Fig. 9(b)의 음영 영역을 통해서 확인할 수 있다. 그러나 이 변동은 순수한 측정 노이즈가 아니라 공정 조건의 차이에서 비롯된 것이다. Fig. 9의 분석은 조성만을 기준으로 시료를 그룹화한 결과이며, 본 데이터셋에는 소결 온도・시간, 1차 및 2차 템퍼링 온도・시간, 분말 입도 등 7종의 공정 변수가 모두 포함되어 있다. 실제로 조성과 공정 변수를 함께 포함하여 그룹화하면 반복 그룹은 19개로 줄고, 보자력 변동 범위는 최대 51.6 kA・m-1, 평균 6.0 kA・m-1로 급감한다. 즉 조성과 공정이 모두 동일한 시료 간의 보자력 차이는 측정 오차 수준에 불과하므로, 본 데이터셋 구성요소의 일관성은 우수함을 확인할 수 있다.
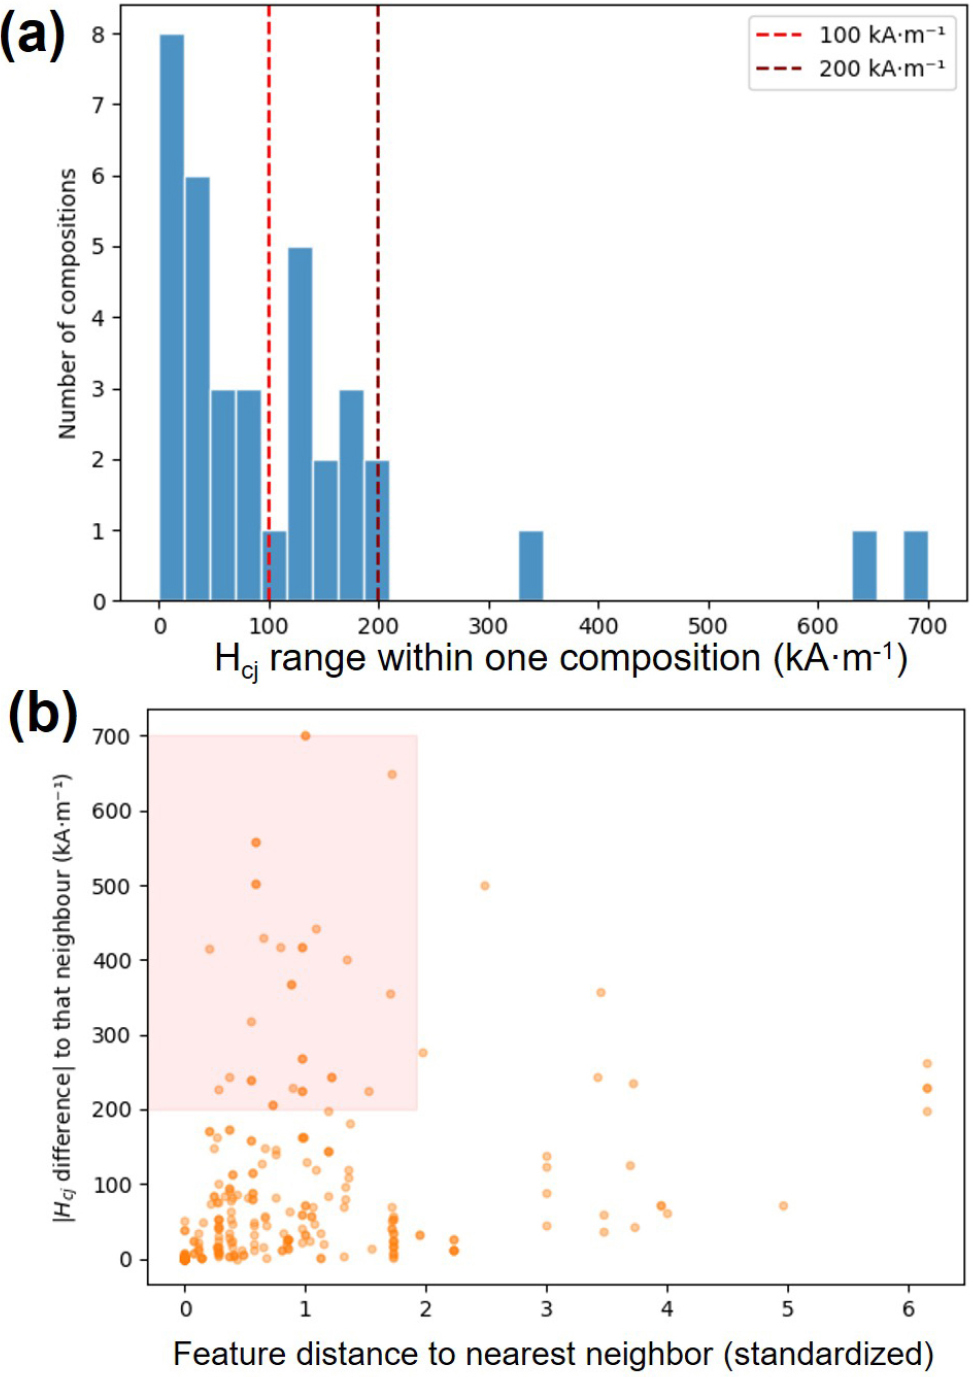
Fig. 9.
Assessment of dataset label consistency. (a) Histogram of the coercivity (Hcj) range within groups of identical composition (36 repeated compositions); the dashed lines mark reference variations of 100 and 200 kA・m-1. (b) Absolute Hcj difference between nearest-neighbor pairs plotted against their standardized feature distance; the shaded region highlights near-identical inputs (small feature distance) that nonetheless differ by more than 200 kA・m-1.
따라서 테스트 데이터에서 관측된 큰 우연적 불확실성은 데이터의 본질적 노이즈에서 기인하는 것이 아니라, Dy 미학습에 따른 외삽 편향이 단순 분산 차감 과정에서 우연적 성분으로 흡수된 결과로 해석하는 것이 타당하다. 다만 조성만으로 그룹화했을 때 나타나는 큰 변동은, 공정 조건이 보자력에 미치는 영향이 상당함을 보여준다. 나아가 본 데이터에 수치로 포함된 공정 변수 외에도, 미세구조나 결정립계 확산과 같이 현재 정량화되지 않은 요인이 보자력을 추가로 좌우할 수 있다. 이러한 비정형 미세구조 정보는 거대언어모델(large language model, LLM)을 이용한 문헌 텍스트 임베딩 등을 통해 특징으로 변환될 수 있으며, 향후 이러한 변수를 예측 모델에 체계적으로 반영하는 것이 정확도 향상에 기여할 수 있을 것으로 기대된다.
4. 결 론
본 연구는 랜덤 포레스트 기반 불확실성 분해를 NdFeB 소결자석의 보자력 예측에 적용하여 다음을 규명하였다.첫째, 첨가 원소별 데이터 분포 분석을 통해 Dy가 Tb보다 함량-물성 관계 분석 및 외삽 실험에 적합한 대상임을 확인하였다. 둘째, Dy를 학습에서 제외한 외삽 상황에서 예측 성능이 R2 = 0.965에서 R2 = -0.994로 붕괴하고 불확실성이 급증함을 보여, 불확실성 분해가 미지 조성에 대한 외삽 위험을 정량적으로 경고하는 도구가 될 수 있음을 제시하였다. 셋째, 인식론적/우연적 불확실성 기반 획득 점수로 선별한 ‘최적 후보’(저Dy)를 실제 학습에 추가하여도 성능이 개선되지 않은 반면(∆R2 = +0.029), ‘피해야 할’ 시료로 분류된 고Dy 시료를 추가할 때 성능이 크게 향상됨을 직접 검증하였다(∆R2 = +0.508). 이 상반된 결과는 개별 트리 예측 분포 분석과 라벨 일관성 검증을 통해 설명된다. 즉 고Dy 시료에서 나타난 높은 우연적 불확실성은 데이터의 본질적 노이즈가 아니라, Dy 미학습에 따른 외삽 편향이 단순 분산 차감 과정에서 우연적 성분으로 흡수된 결과임을 확인하였다. 따라서 극단적 외삽 상황에서는 이 획득 점수가 모델 편향을 우연적 불확실성으로 오분류하여 능동 학습 후보 선정 지표로 부적절할 수 있으며, 오히려 예측 오차가 큰 외삽 영역의 시료를 우선 확보하는 전략이 데이터 효율 측면에서 더 유효함을 확인하였다. 한편, 조성이 동일함에도 보자력이 넓게 분포하는 현상은 소결 열처리 등 공정 조건의 영향이 상당함을 보여주며, 미세구조・결정립계 확산과 같이 현재 정량화되지 않은 설명변수의 확보가 예측 정확도 향상의 근본 과제임을 시사한다. 향후 이러한 변수를 체계적으로 반영하고 데이터 규모를 확대하는 한편, 불확실성 기반 능동 학습을 반복 적용함으로써 최소한의 실험으로 예측 모델을 효율적으로 고도화하는 연구가 기대된다.